Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Développeur Backend et spécialiste en IA locale : Laravel, Python, RAG
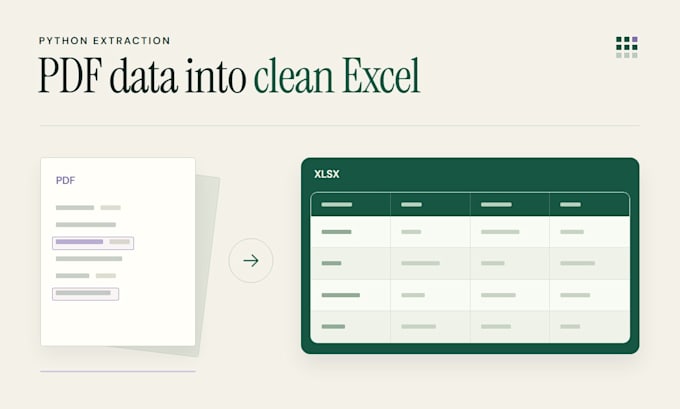
Transformez des rapports PDF répétitifs en un fichier Excel ou CSV propre et exploitable.
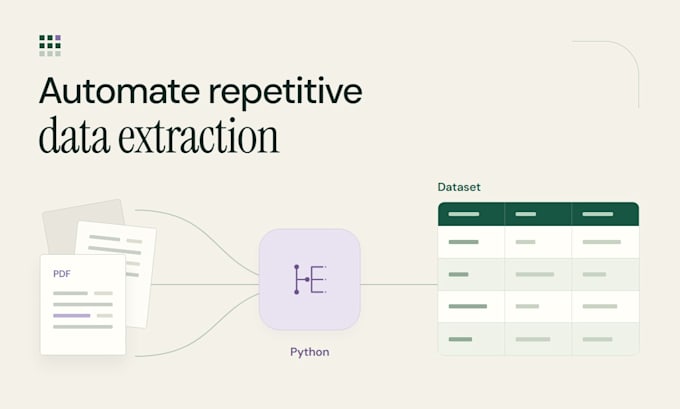
Je conçois des flux d’extraction Python pour des PDFs lisibles basés sur du texte avec des mises en page cohérentes. Vous définissez les colonnes; je mappe les champs convenus, j’opère l’extraction sur l’ensemble de la série et je vérifie la structure de sortie.
Le pack Basic couvre jusqu’à 20 pages et une seule mise en page. Standard ajoute jusqu’à 70 pages, deux mises en page et un script Python réutilisable. Premium couvre jusqu’à 150 pages et trois mises en page, avec des contrôles de validation convenus et une documentation d’exécution. Limites par champ, fichier et ligne s’appliquent.
Vous recevez une sortie structurée, un court résumé d’extraction et une liste claire de ce qui nécessite une révision. Standard et Premium incluent également le script source. Les sorties sont vérifiées par rapport au schéma convenu ; l’extraction PDF peut nécessiter une révision manuelle.
Veuillez me contacter avec un échantillon redacté de chaque mise en page et vos colonnes cibles avant de commander. Les scans, l’écriture manuscrite, l’OCR avancé, les templates en évolution et les règles métier complexes nécessitent une évaluation séparée.
Technologie:
Excel
•
Google Sheets
•
Python
Traduction automatique
Quels PDFs pouvez-vous traiter ?
Les PDFs lisibles basés sur du texte avec des étiquettes de champs ou des structures de tableaux cohérentes conviennent le mieux. Envoyez un échantillon redacté de chaque mise en page avant de commander afin que je puisse évaluer l’extraction et confirmer le package.
S’agit-il de saisie manuelle de données ?
Le service utilise Python pour extraire des structures de données répétables. Il est destiné à des formats de documents récurrents, avec un schéma défini et une sortie vérifiée. La transcription manuelle de documents variés ne fait pas partie de cette offre.
Qu’est-ce qui compte comme une mise en page différente ?
Une mise en page utilise les mêmes étiquettes de champ, les mêmes positions de champ et la même structure de tableau. Des valeurs ou dates différentes sont généralement acceptables. Une structure d’en-tête modifiée, un champ déplacé ou une nouvelle disposition de tableau peuvent nécessiter une logique d’extraction distincte et être comptées comme une autre mise en page.
Le résultat sera-t-il à 100 % fiable ?
Aucun pourcentage d’exactitude n’est garanti. Je passe en revue des sorties représentatives, vérifie la structure convenue et signale les exceptions détectées. Les PDFs peuvent contenir du texte manquant ou des formats inhabituels; vous devrez donc vérifier les valeurs signalées avant de vous fier aux données.
Pouvez-vous traiter les PDFs scannés ou l’écriture manuscrite ?
Les scans, les PDFs uniquement image, l’écriture manuscrite, l’OCR avancé et les documents de faible qualité nécessitent une évaluation séparée et un devis personnalisé. Ils ne font pas partie de ces packs.