Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Data Scientist, ingénieur en IA
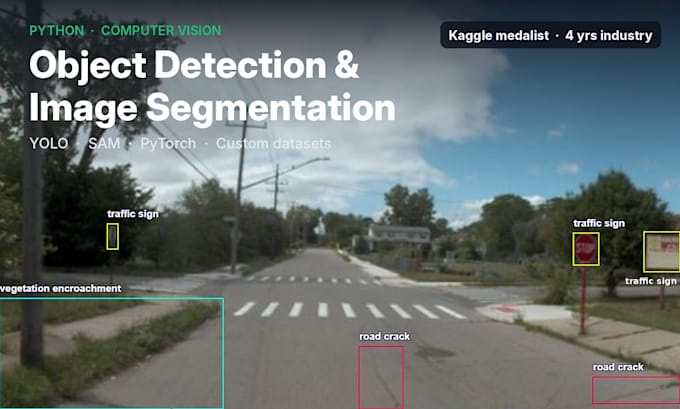
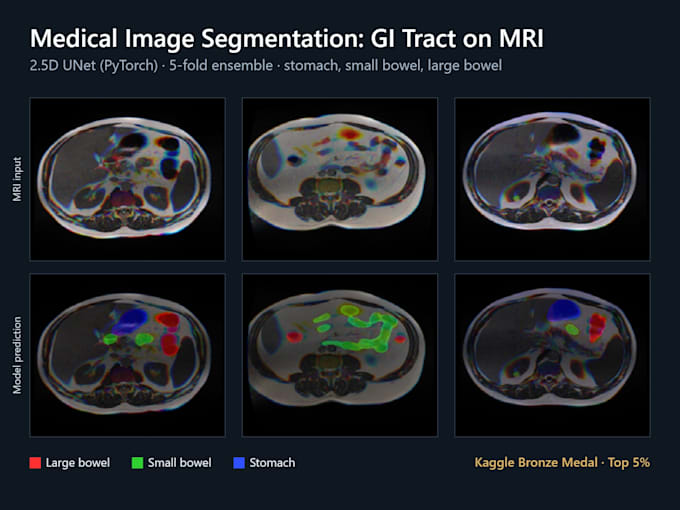
Besoin d'un modèle de vision par ordinateur qui fonctionne sur vos propres images ? Je forme, ajuste et passe en revue des modèles de détection d'objets et de segmentation d'images en Python.
Ce que je peux faire :
Pourquoi moi :
Comment cela fonctionne :
Les résultats dépendent de la qualité des données. Je ne promets pas une métrique spécifique, mais je rends compte exactement de ce qui a été obtenu et pourquoi.
Veuillez me contacter avant de commander. Ne comprend pas : étiquetage des données, déploiement en périphérie, systèmes vidéo en temps réel.

Expertise:
Traitement d'images
•
Classification
•
Détection d'objets
Langage de programmation:
Python
•
Colab
•
MLflow
•
Amazon SageMaker
Outils:
Jupyter Notebook
•
opencv
•
tensorflow
•
MLflow
•
CVAT
•
Colab
•
PyTorch
Frameworks:
Scikit-learn
•
PyTorch
Traduction automatique
Étiquetez-vous les données ?
Non, un jeu de données étiqueté est nécessaire (YOLO, COCO ou format masque). Je peux conseiller sur les outils d’étiquetage et la qualité des étiquettes.
Que vais-je recevoir ?
Revue de pipeline : un rapport écrit listant les principales causes d’erreur et un plan de correction. Standard/ Premium : code Python, poids entraînés, un script d’inférence et des métriques. Premium ajoute un rapport écrit incluant des cas d’erreur.
Quelle est la taille maximale de mon jeu de données ?
Standard et Premium couvrent jusqu’à 2 000 images étiquetées et 10 classes. Pour des jeux de données plus importants, envoyez-moi un message pour une offre personnalisée.
Où le modèle est-il entraîné ?
Sur mon propre GPU, ou sur votre compte Google Colab ou cloud si vous préférez garder les données là-bas.