Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur senior en Web Scraping, spécialiste en extraction de données Python
Vous souhaitez extraire des données propres et fiables de sites modernes riches en JavaScript ou d'applications monopage (SPA) ? Vous êtes au bon endroit !
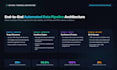
Je suis un ingénieur senior en web scraping et en gestion de données, fondateur de HLP Data. Je conçois des pipelines de crawling de niveau production qui récoltent des millions d’enregistrements structurés chaque semaine avec une disponibilité de 99,8 %.
Ce que je maîtrise :
Web scraping dynamique : automatisation de navigateur sans tête (Playwright/Chromium) pour React, Vue, Next.js et portails AJAX.
Scroll infini et pagination : extraction exhaustive de catalogues sans manquer d’éléments.
Gestion intelligente du trafic : limitation de débit par domaine et gestion de sessions multi-proxy.
Formats de production propres : CSV, TSV, JSON, PostgreSQL, MySQL ou téléchargement direct vers Amazon AWS S3.
Code source complet inclus : scripts Python propres avec guides d’installation pour une planification automatisée via cron.
Pourquoi me choisir ?
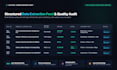
Je fournis des jeux de données validés à 100 % (zéro null dans les champs obligatoires)
Délais rapides de 24 à 48 heures
Révisions illimitées et garantie de satisfaction à 100 %
Veuillez m’envoyer un message avec votre URL cible et les champs requis avant de passer commande. Discutons de votre projet !


Technologie:
Python
•
scrapy
•
sélénium
•
Beautiful Soup
•
Playwright
Technique:
Automatisé(e)


