Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Analyste de données
Des données désordonnées retardant vos insights commerciaux ou pipelines de machine learning ? Je vais nettoyer, interroger et transformer vos jeux de données bruts en utilisant Python et SQL pour les rendre prêts à la production à 100 %.
Ce que je propose :
Nettoyage de données Python : gestion des valeurs manquantes, suppression des doublons, mise en forme structurelle, correction des types de données et traitement des anomalies structurelles avec Pandas et NumPy.
Requêtes SQL : rédaction de requêtes optimisées et propres utilisant des jointures, fonctions de fenêtrage, opérations d'agrégation et sous-requêtes pour extraire des métriques ciblées.
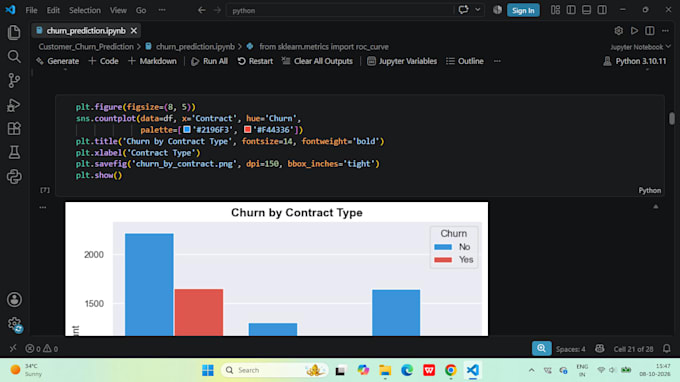
Analyse exploratoire de données (EDA) : détection de distributions cachées, suivi des matrices de corrélation et création de visualisations synthétiques claires.
Prétraitement des fonctionnalités : gestion des valeurs aberrantes, encodage des catégories et mise à l’échelle des données pour une structuration parfaite pour l’analyse.
Livrables :
Vous recevrez des notebooks Python Jupyter entièrement commentés (.ipynb), des fichiers de scripts propres (.py), des scripts de requêtes SQL structurés (.sql) et vos jeux de données finalisés en formats CSV/Excel.
Veuillez m’envoyer un message court précisant le format de votre dataset et vos objectifs analytiques avant de passer commande afin que nous puissions définir le projet parfaitement !
Traduction automatique
Quelles bibliothèques utilisez-vous pour le nettoyage et l’analyse de données en Python ?
J’utilise principalement Pandas et NumPy pour un nettoyage, un prétraitement et une manipulation efficaces des données. Pour l’analyse exploratoire (EDA) et les visualisations, j’utilise Matplotlib et Seaborn pour créer des graphiques statistiques clairs.
Pouvez-vous travailler avec de grandes bases de données ou des serveurs cloud ?
Oui ! Je peux rédiger des requêtes SQL optimisées pour des dumps de bases de données locaux (.sql) ou me connecter directement à des bases relationnelles standard. Pour de grands jeux de données, je m’assure que les requêtes utilisent des jointures et des index efficaces pour minimiser la charge de traitement.