Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Analyste de données passionné de machine learning
Votre modèle est aussi bon que les données que vous lui fournissez. Je m'assure que les données sont réellement prêtes.
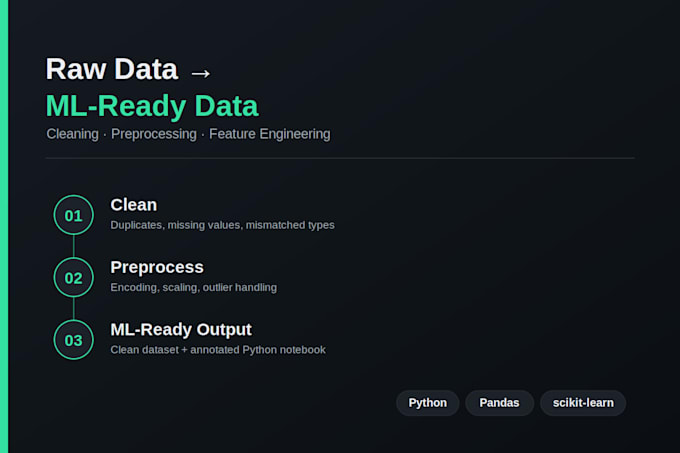
Je nettoie, prétraite et prépare des datasets spécifiquement pour l'utilisation en machine learning, pas seulement des feuilles de calcul rangées, mais des données vraiment prêtes à être intégrées dans un modèle : correctement encodées, normalisées, les valeurs manquantes traitées avec une stratégie défendable, et documentées pour que vous compreniez exactement ce qui a été fait et pourquoi.
Ce que vous obtenez :
Idéal pour : étudiants et chercheurs préparant des données pour une thèse ou un article, startups construisant leur premier pipeline ML, data scientists souhaitant déléguer le travail fastidieux, concurrents Kaggle manquant de temps.
Comment ça marche :
_khk6yj.jpg)
Technologie:
Excel
•
Google Sheets
•
Python
•
SAS
Traduction automatique
Dans quel format dois-je envoyer mes données ?
CSV, Excel ou JSON fonctionnent tous. Si cela provient d'une base de données ou d'une API, dites-le-moi et nous trouverons la meilleure exportation.
Construirez-vous un modèle ML complet pour moi ?
Les modèles de référence sont inclus dans Premium comme vérification de la qualité des données, pas comme modèle de production. Le développement complet d'un modèle est un scope séparé — contactez-moi.
Comment gérez-vous les données manquantes ?
Cela dépend des données et de votre cas d'utilisation — je choisirai (et expliquerai) entre suppression, imputation par la moyenne/médiane, ou des méthodes plus avancées comme l'imputation KNN, et je vous expliquerai les compromis.
Pouvez-vous travailler avec des datasets de plus de 50 000 lignes ?
Oui, contactez-moi d'abord pour un devis personnalisé — les datasets plus volumineux sont tarifés en fonction de leur complexité, pas seulement du nombre de lignes.