Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
Veuillez m’envoyer un message avant de passer commande - envoyez un document d’exemple et je vous confirmerai ce qui est possible.
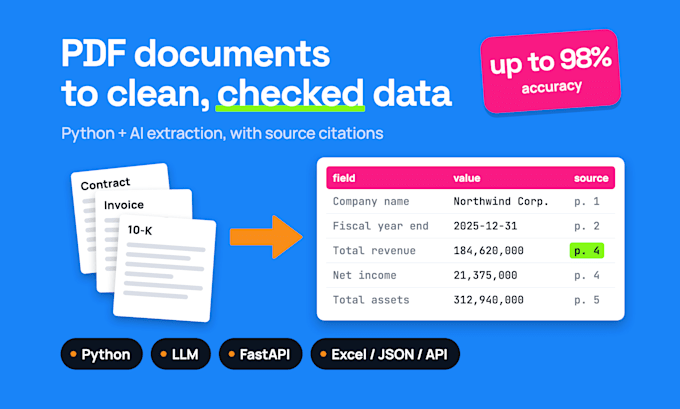
Vous retapez encore des chiffres à la main à partir de PDFs ? Factures, contrats, dossiers d’appel d’offres, états financiers : une erreur de lecture coûte plus cher que toute l’extraction.
Je crée des pipelines Python qui transforment vos documents en tableaux propres - et indiquent d’où provient chaque valeur, pour que vous puissiez vérifier plutôt que faire confiance.
Ce que vous obtenez :
Pourquoi me choisir :
Ce n’est pas fait pour des tâches ponctuelles de copier-coller que vous pouvez réaliser avec ChatGPT.
Envoyez-moi un message avec un document d’exemple et ce que vous souhaitez en tirer.
Python AI developer, over 12 years in IT, document AI and RAG in production
Langues
Traduction automatique
Traduction automatique
Pourquoi me choisir ?
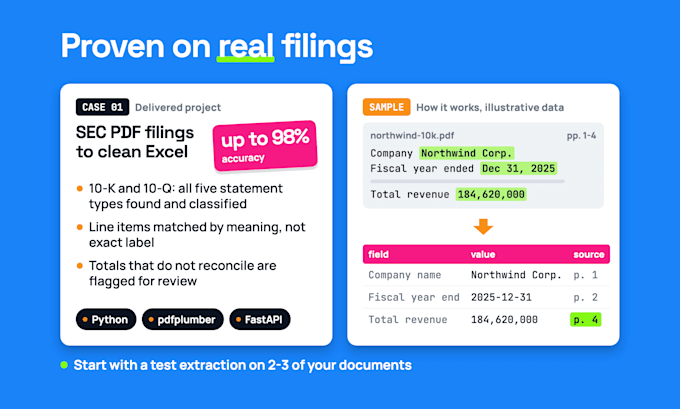
Je construis des extractions que vous pouvez vérifier : chaque valeur conserve sa page source, et les valeurs sur lesquelles le système n’est pas sûr sont signalées, pas devinées. Preuve : déclarations SEC 10-K/10-Q extraites vers Excel avec une précision allant jusqu’à 98 %, plus de 12 ans dans l’IT.
Ce qui est inclu?
Les livrables du package, le code source (Docker inclus), un rapport de précision sur vos propres documents d’échantillon, et une courte transmission écrite.
Qu'est-ce qui n'est pas inclus ?
Saisie manuelle des données, coûts d’hébergement, frais API LLM, et types de documents non convenus dans la commande. Des types de documents supplémentaires peuvent être ajoutés ultérieurement en tant qu’option.
Mes données sont-elles en sécurité ?
Oui. Je suis prêt à signer votre NDA avant de partager des documents. Je n’utilise vos fichiers que pour cette commande et je les supprime après livraison.
Pouvez-vous tester sur mes propres documents avant de commander la réalisation complète ?
Oui, c’est l’objectif du package Basic : je réalise l’extraction sur 2 à 3 de vos documents et vous envoie un rapport de précision ainsi qu’un plan. Vous décidez de la réalisation complète seulement après avoir vu des chiffres concrets.
Quelle sera la précision, et comment la mesurez-vous ?
Cela dépend de vos documents, donc je la mesure plutôt que de la promettre : chaque champ extrait est comparé à la valeur correcte sur vos échantillons, et vous recevez la précision par champ dans le rapport.
Gérez-vous les PDFs scannés (OCR) ?
Oui. Les PDFs texte sont lus directement ; les PDFs scannés passent par OCR. La qualité du scan influence la précision, donc les PDFs scannés sont testés en premier dans le package Basic sur vos propres fichiers, avant de vous engager dans la réalisation complète.
Pouvez-vous extraire des tableaux de PDFs ?
Oui. Les tableaux sont au cœur de mon travail sur les SEC 10-K/10-Q (états financiers). Chaque tableau sort sous forme de lignes et colonnes dans Excel, CSV ou JSON, avec la page source conservée pour chaque valeur.
Quels formats de sortie livrez-vous ?
Excel, CSV ou JSON par défaut. Avec l’option Export To Sheet & DB, les données vont directement dans votre Google Sheet ou votre base de données.
Peut-il fonctionner sur mon propre serveur ?
Oui. Le package Premium est livré dans Docker, donc le pipeline fonctionne sur votre propre serveur et vos documents restent avec vous.