Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données
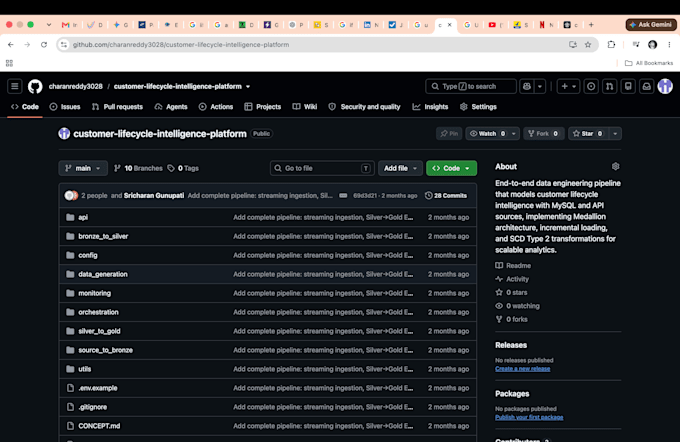
Je vais construire des pipelines de données fiables et efficaces en utilisant Python, SQL, PySpark et des workflows ETL modernes.
Que vous disposiez de données CSV, Excel, JSON, API ou base de données, je peux vous aider à extraire, nettoyer, transformer, valider et préparer ces données pour l’analyse, le reporting ou des applications en aval.
Mes services incluent :
Traitement et automatisation de données avec Python
Requêtes SQL et transformation de données
Développement de pipelines ETL
Traitement de données avec PySpark
Nettoyage et validation de données
Extraction de données via API ou fichiers
Intégration de données entre bases
Transformation de données et automatisation des workflows
Documentation de base des pipelines
Je me concentre sur l’écriture d’un code propre, facile à maintenir et efficace, adapté à vos besoins.
Si vous avez une petite tâche de données, un workflow ETL ou un besoin plus important en pipelines, n’hésitez pas à me contacter avec vos exigences avant de passer commande. Je réviserai votre projet et vous proposerai la solution la plus adaptée.
Plateforme de stockage:
BigQuery
Type de projet:
Optimisation
