Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données et cloud
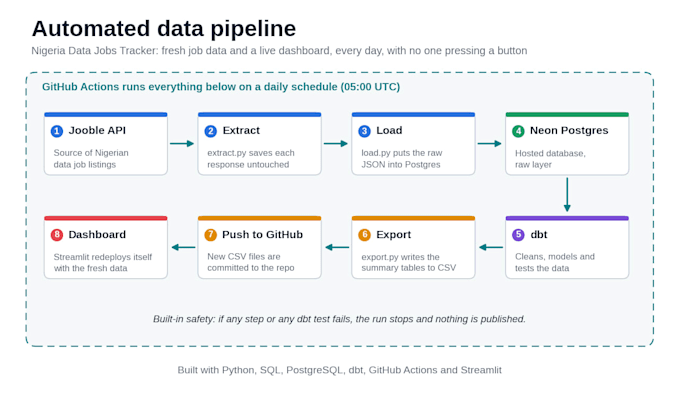
Besoin que vos données soient collectées, nettoyées et mises à jour automatiquement ? Je crée des pipelines de données qui fonctionnent tout seuls, vous disposerez ainsi en permanence de données fraîches et fiables.
CE QUE JE CONSTRUIS
- Extraction depuis des APIs et des fichiers avec Python
- Chargement dans PostgreSQL
- Nettoyage et modélisation avec dbt, avec tests de qualité des données
- Automatisation quotidienne avec GitHub Actions, aucun serveur nécessaire
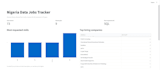
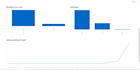
- Un tableau de bord Streamlit en direct accessible via un lien et aussi vers toute destination finale de votre choix
LA PREUVE QUE CELA FONCTIONNE
J’ai construit et géré Nigeria Data Jobs Tracker : il récupère les offres d’emploi chaque jour, les nettoie avec dbt et met à jour un tableau de bord public automatiquement.
Démonstration en direct: nigeria-job-market-tracker-c2dqzraz9ouopa9qo4cgnt.streamlit.app
MODE DE TRAVAIL
- Vous me dites votre source de données et ce que vous souhaitez voir
- Je conçois le pipeline et remets le code
- Des tests s’exécutent à chaque mise à jour, afin que les données erronées soient détectées avant d’atteindre votre tableau de bord
Outils : Python, SQL, PostgreSQL, dbt, GitHub Actions, Streamlit, Docker.
Envoyez-moi un message avant de commander avec une description courte de vos données, et je recommanderai le bon package.
Traduction automatique
De quoi avez-vous besoin de ma part pour commencer ?
La source de données (une API, des fichiers ou une base de données), ce que vous souhaitez mesurer et l’endroit où les données doivent être stockées.
Le pipeline peut-il s'exécuter automatiquement chaque jour ?
Oui. Le package Premium inclut un planning quotidien avec GitHub Actions, il s’exécute donc sans intervention.
Est-ce que j'obtiens le code source ?
Oui, tous les packages incluent le code source complet.