Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur en IA, Machine Learning, Python, Développeur FullStack
Des données propres déterminent jusqu’où va un projet. Si les enregistrements sont incohérents, les dossiers sont en désordre ou les images ne portent aucune étiquette, l’algorithme n’est pas le problème.
Je collecte, étiquette, nettoie et prépare des ensembles de données :
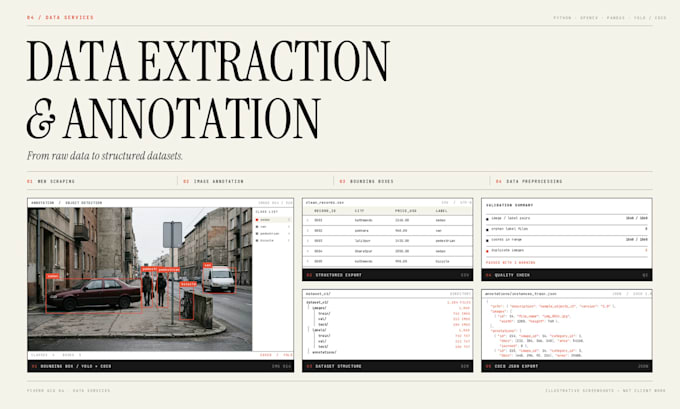
- Web scraping : extraction de données publiques autorisées en CSV, Excel ou JSON, avec un dictionnaire de colonnes
- Annotation d’images : étiquetage de classification, catégories et définitions de classes cohérentes
- Boîtes englobantes : annotation de détection d’objets au format YOLO ou COCO
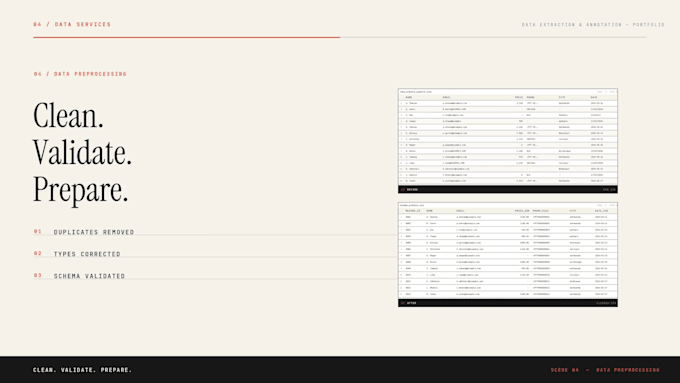
- Prétraitement : doublons, valeurs manquantes, types de données, formatage, normalisation
- Préparation de l’ensemble : structure des dossiers, appariement image-étiquette, répartition, validation, documentation
Outils : Python, Pandas, BeautifulSoup, Requests, Selenium/Playwright, OpenCV. Résultats : CSV, Excel, JSON, YOLO, COCO JSON, dossiers organisés.
Chaque livraison inclut les fichiers traités, un résumé de qualité et des notes sur ce qui a changé. Les originaux sont conservés.
Envoyez-moi un message avant de commander avec votre source de données, la quantité, les classes et le format de sortie requis afin que le périmètre et le prix puissent être convenus au préalable. Sources publiques et autorisées uniquement. Je ne forme pas de modèles ni ne développe d’applications dans le cadre de ce gig.


Traduction automatique
Pouvez-vous gratter n'importe quel site Web?
Non — tout vendeur qui dit oui ne fait que deviner. Je collecte à partir de sources publiques auxquelles vous avez droit, en respectant les limites de fréquence et les conditions d’utilisation. Les sites derrière des connexions, des paywalls, des CAPTCHA ou des protections anti-bot échappent à ce périmètre, et les sites bloquant l’accès automatisé peuvent être refusés après vérification.
Dans quels formats de données livrez-vous ?
CSV, Excel (XLSX), JSON, fichiers YOLO .txt avec un data.yaml, COCO JSON, dossiers d’images organisés et documentation en Markdown ou PDF. Un seul format de sortie est inclus dans un package ; un second format pour les mêmes données est disponible en supplément.
Pouvez-vous annoter les images avec des boîtes englobantes ?
Oui. J’annoterai les objets selon une convention convenue avant le début du travail : précision des boîtes par rapport à l’objet, prise en compte des objets partiellement visibles, nombre de boîtes par image et nommage des classes. Les boîtes peuvent être livrées avec votre liste de classes appliquée exactement telle quelle.
Privilégiez-vous les formats YOLO et COCO ?
Oui, les deux — YOLO avec des fichiers .txt normalisés et un data.yaml, et COCO JSON avec images, annotations et catégories. Je peux aussi effectuer des conversions entre eux ou produire un CSV de coordonnées en pixels si cela est nécessaire pour votre pipeline.
Pouvez-vous nettoyer et prétraiter un ensemble existant ?
Oui. Cela inclut la suppression des doublons avec un compte rendu, la gestion des valeurs manquantes selon votre choix, la correction des types et des dates, le nettoyage des espaces et de la casse, le renommage des colonnes, le redimensionnement des images et la validation du résultat. Les originaux sont conservés et un bref journal de transformation est livré avec l’ensemble nettoyé.
Pouvez-vous organiser les images et les étiquettes dans des dossiers ?
Oui. Je mets en place les structures images/, labels/ et annotations/, réparties en train/validation/test comme convenu, vérifie que chaque image a un fichier d’étiquette correspondant, signale les fichiers orphelins et ajuste les comptes entre les répertoires.
Formez-vous des modèles d'apprentissage automatique ?
Pas dans ce gig. Ce service se limite à la collecte de données, étiquette, nettoyage, structure et documentation. L’entraînement de modèle, l’ajustement et l’évaluation constituent un service séparé — un ensemble de données préparé peut alimenter ce travail, mais ce n’est pas inclus dans cette commande.
Pouvez-vous gérer de grands ensembles de données ?
Dans les quantités indiquées pour chaque package (jusqu’à 1500 enregistrements ou 250 images annotées dans Premium). Des volumes plus importants sont possibles mais feront l’objet d’un devis séparé après que j’aie examiné l’échantillon, car l’effort d’annotation varie en fonction du nombre d’images × classes × objets par image, et non pas uniquement par la taille du fichier.
Comment la qualité de l’annotation est-elle vérifiée ?
Selon les critères convenus avant la commande : la feuille de définition des classes, vos instructions écrites, un pourcentage de révision convenu (par exemple 10 % des images revues), et les conventions consignées dans le brief. Les cas ambigus sont consignés plutôt que décidés tacitement. Ce que je n’offre pas est une approbation générale sans vérification.
Dois-je envoyer quelque chose avant de commander ?
Un bref cahier des charges : à quoi servent les données, où elles se trouvent, leur volume, les noms des classes si une annotation est impliquée, et le format souhaité. Des captures d’écran d’un fichier d’annotation existant aident beaucoup. Envoyez-le par message et vous obtiendrez une note de périmètre avec quantité, format, prix et délai de livraison.