Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Analyse de données par un biologist spécialiste chez AbyssalAnalytics
Êtes-vous étudiant diplômé, chercheur ou académicien qui lutte avec du code cassé ou un ensemble de données désorganisé ? En tant qu’analyste de données avec une licence en biologie et une mineure en sciences psychologiques, je comprends que vos données représentent des heures d’observations minutieuses et de travail physique, et ne se limitent pas à des feuilles de calcul d’entreprise. Je me spécialise dans l’exécution mécanique du nettoyage des données afin que vous puissiez vous concentrer entièrement sur votre thèse, les directives du comité ou d’autres sujets urgents.
Ce que je fais :
Débogage de code : suppression des erreurs de syntaxe, des boucles ou des avertissements de mise en page dans vos notebooks Jupyter.
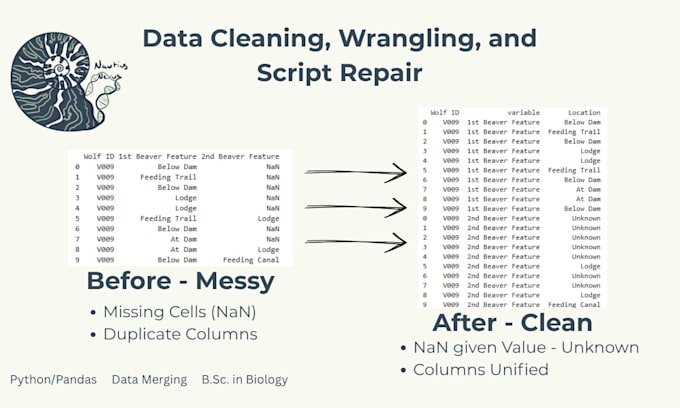
Nettoyage des données : restructuration des formats bruts, gestion des cellules manquantes et normalisation des catégories textuelles.
Intégration multi-flux : synchronisation jusqu’à 3 journaux ou feuilles de calcul séparés en un seul jeu de données unifié.
À noter : pour protéger l’intégrité des données, votre fichier brut et vos hypothèses de recherche sont bloqués une fois la commande lancée.
Pour les ensembles de données volumineux dépassant les seuils de lignes de base, veuillez ajouter l’extra “Données ou Fichier supplémentaires” lors du paiement. Pour un cahier de projet additionnel, sélectionnez le même. Si vous souhaitez une explication du code, sélectionnez “Documentation du Code”.
Consultez mon code public sur github.com/skyegambrel
Traduction automatique
Quelles sont les formats de fichier que vous acceptez pour le nettoyage des données ?
J’accepte les formats de données tabulaires standards tels que CSV, XLSX (Excel), TSV et TXT, ainsi que les fichiers de script Jupyter Notebook (.ipynb) pour le débogage. Veuillez vous assurer que vos structures de fichiers ne sont pas chiffrées avant de les télécharger dans le panneau des exigences.
Qu’est-ce qu’un seul « Item Cleaned » ou fichier de dataset ?
Un seul élément correspond à une feuille de calcul, un tableau ou un cahier source indépendants. Le niveau 1 couvre un seul script cassé, le niveau 2 couvre un seul fichier de données brut (jusqu’à 200 lignes), et le niveau 3 couvre le nettoyage et l’intégration structurelle de jusqu’à 3 fichiers séparés.
Comment gérez-vous les valeurs manquantes, les cellules vides ou les NaN dans mon jeu de données ?
J’utilise des bibliothèques Python spécialisées (Pandas et NumPy) pour isoler les motifs de données manquantes. Selon vos instructions, j’écris des pipelines propres pour supprimer les lignes vides, combler les lacunes structurelles ou imputer les catégories manquantes selon les exigences de votre projet—sans fabrication.
Pouvez-vous expliquer le code Python ou les bibliothèques utilisées pour nettoyer mes fichiers ?
Les niveaux de base livrent le fichier de données nettoyé et votre script annoté. Si vous avez besoin d’une explication complète mot par mot en anglais clair des fonctions Pandas exactes utilisées afin de défendre aisément le pipeline de données devant votre comité, veuillez choisir l’extra « Documentation du Code » lors du paiement.
Signerez-vous des accords de non-divulgation (NDA) ou des clauses de confidentialité des données ?
Conformément aux règles strictes et sécurisées de la plateforme Fiverr, vos fichiers sources bruts, notes d’observation et hypothèses restent strictement confidentiels et ne sont jamais partagés ou publiés.
