Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données senior
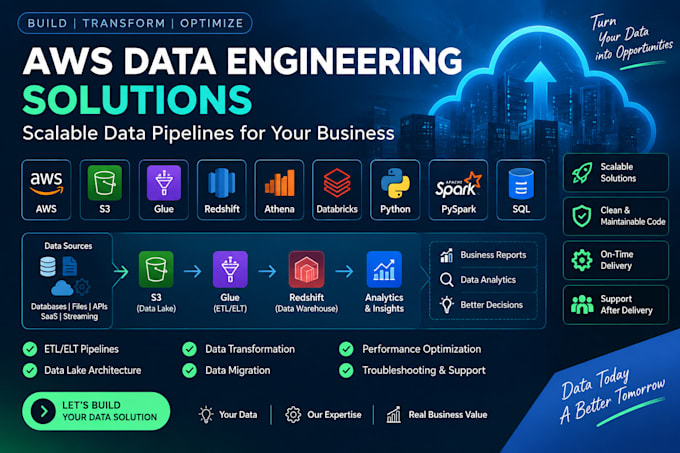
Vous cherchez un Data Engineer expérimenté pour créer des pipelines de données fiables et évolutifs ?
Je vais développer et optimiser des solutions d'ingénierie des données AWS, ETL/ELT et traitement de données en utilisant Python, PySpark, SQL, AWS Glue, S3, Redshift, Athena et Databricks.
Voici ce que je peux vous aider à réaliser :
Je me concentre sur la création de solutions de données propres, évolutives, faciles à maintenir et prêtes pour la production selon vos besoins métier.
Que vous ayez besoin d’un nouveau pipeline de données, d’optimiser un workflow existant ou d’aide pour dépanner votre projet d’ingénierie des données, je suis là pour vous aider.
Technologies : AWS | Python | PySpark | SQL | Glue | S3 | Redshift | Athena | Databricks | Delta Lake
Expertise:
CI/CD
•
Surveillance et journalisation
•
Automatisation
Fournisseur de services cloud:
Amazon Web Services
