Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
Vous avez besoin d'une architecture backend fiable pour un système de chat de documents AI ?
Ce que je peux construire
Je peux concevoir autour de problématiques telles que :
Envoyez-moi vos types de documents, volume de pages attendu et pile technologique préférée, et je vous aiderai à planifier le pipeline backend.
Your AI System Built Right From Day One
Langues
Traduction automatique
Traduction automatique
Pouvez-vous créer un chatbot qui répond aux questions à partir de mes documents PDF ?
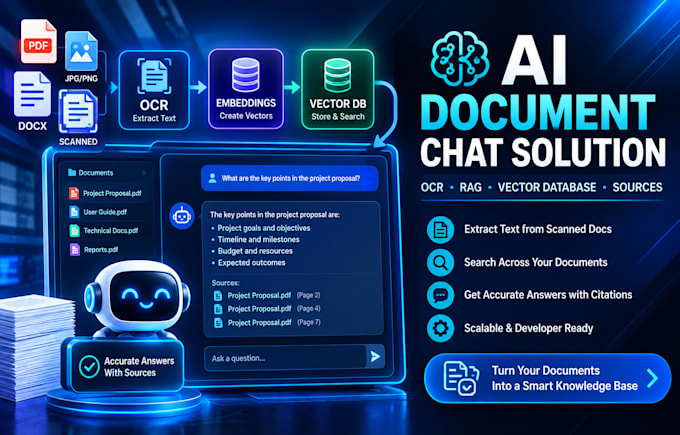
Oui. Je peux créer un système de chat de documents où les utilisateurs téléchargent des PDFs et posent des questions, avec des réponses générées à partir du contenu du document.
Et si mes PDFs sont scannés et n'ont pas de texte sélectionnable ?
Je peux ajouter un pipeline OCR pour extraire le texte des PDFs scannés et basés sur des images avant de les traiter pour la recherche et le chat AI.
Mon chatbot AI donne des réponses qui ne sont pas réellement dans mes documents. Pouvez-vous corriger cela ?
Oui. Je peux concevoir un pipeline RAG avec un meilleur découpage des documents, récupération, métadonnées et ancrage des sources pour réduire les réponses non supportées.
Le chatbot peut-il m'indiquer d'où provient une réponse ?
Oui. Le système peut retourner des informations sur la source telles que le nom du document, le numéro de page, la section ou le texte récupéré en complément de la réponse.
J'ai des milliers de documents. Peuvent-ils tous être consultés avec l'IA ?
Oui. Je peux concevoir une architecture scalable d'ingestion, d'embedding et de recherche vectorielle pour de grandes collections de documents.
Mes documents scannés contiennent des tableaux, colonnes ou mises en page inhabituelles. L'OCR fonctionnera-t-il toujours ?
Ces mises en page peuvent poser des problèmes d'extraction. Je peux concevoir des étapes de prétraitement et de validation pour gérer les points faibles courants de l'OCR et améliorer la qualité du contenu extrait.
