Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données
Vous avez besoin d’un ingénieur de données senior pour des pipelines ETL/ELT évolutifs, le traitement de Big Data, l’entreposage de données ou des architectures Lakehouse ?
Je suis Muhammad Ahmed, ingénieur de données avec plus de 4 ans d’expérience dans la création de plateformes de données pour entreprises sur AWS, Azure, GCP et Snowflake.
Services que je propose :
Technologies :
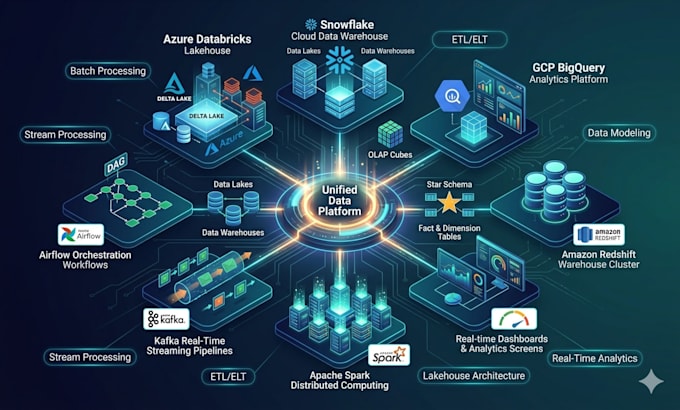
Azure Databricks, Snowflake, GCP BigQuery, Amazon Redshift, Apache Spark, PySpark, Kafka, Airflow, DBT, Snowflake SQL, SparkDF, PostgreSQL, AWS, Docker, Python, SQL.
Je conçois des solutions d'ingénierie des données évolutives, fiables et natives du cloud pour l’analyse, le reporting, l’automatisation et le traitement en temps réel. Et je fournis des données prêtes pour l’IA/ML et l’analytique.
Ingénierie des données, ETL, ELT, Big Data, PySpark, Airflow, Kafka, Snowflake, Databricks, entreposage de données, Redshift, BigQuery.
Plateforme de stockage:
Snowflake
•
BigQuery
•
Databricks
Type de projet:
New Build
Traduction automatique
Quelles plateformes cloud prenez-vous en charge ?
Je travaille avec AWS, Azure, GCP, Snowflake, Databricks, Amazon Redshift et BigQuery.
Concevez-vous des pipelines batch et en flux ?
Oui. Je développe des pipelines batch avec Apache Spark et des solutions en flux avec Kafka et Spark Streaming.
Pouvez-vous concevoir des architectures d’entreposage de données et Lakehouse ?
Oui. Je conçois des lacs de données, entrepôts de données et systèmes Lakehouse évolutifs en utilisant l’architecture Medallion et des plateformes cloud modernes.
Quels outils d’orchestration utilisez-vous ?
Apache Airflow, tâches Snowflake / jobs planifiés, et solutions de planification natives du cloud.
Réalisez-vous la modélisation de données ?
Oui. Je travaille avec schéma en étoile, schéma en flocon de neige, dimensions, tables de faits, modélisation OLAP et OLTP.
Quelles technologies utilisez-vous pour le traitement des données ?
PySpark, Spark SQL, DBT, Snowflake SQL, SparkDF, Python, SQL, Kafka, et outils de traitement natifs du cloud.
Pouvez-vous optimiser les pipelines existants ?
Oui. Je peux améliorer la performance, la scalabilité, l’optimisation des coûts et la fiabilité des systèmes d’ingénierie des données existants.