Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Les difficultés m'ont fait grandir très vite
Vous avez du mal à faire passer vos modèles de machine learning de Jupyter notebooks à des systèmes prêts pour la production ? En tant qu'ingénieur MLOps expérimenté, je comble le fossé entre la data science et l'ingénierie de production.
Je conteneurise les modèles, suis les expériences, mets en place des tests automatisés ou déploie des pipelines cloud robustes adaptés à vos besoins.
Stack MLOps principale :
Pourquoi me choisir ?
Expertise de bout en bout : Expérience avérée dans le déploiement de systèmes complexes, allant des pipelines d’analyse en temps réel aux applications de vision par ordinateur et NLP.
Orienté production : Un code propre et modulaire avec des tests automatisés minimise les bugs et réduit les faux positifs.
Communication claire : Mises à jour régulières et documentation complète pour que votre équipe puisse facilement maintenir le système après livraison.
Transformons votre modèle de machine learning en un atout de production solide dès aujourd’hui ! Contactez-moi avant de commander pour discuter de votre stack personnalisé.
Domaine:
Machine learning
•
Analyse de séries chronologiques
Langage de programmation:
Python
Outils:
Jupyter Notebook
•
tensorflow
•
Excel
•
MLflow
•
Azure ML Studio
Technologie:
Python
•
scikit-learn
•
MLflow
•
Pandas
•
Excel
Traduction automatique
Et si j’ai déjà un modèle mais que je ne sais pas comment le déployer ?
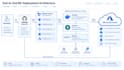
Je prendrai vos artefacts de modèle entraîné (.pkl, .h5, etc.) et les transformerai en un atout prêt pour la production. Cela inclut la conteneurisation (Docker), la création d’une API FastAPI, et la mise en place de CI/CD pour un déploiement fiable sur Azure.
Gérez-vous le processus d’acquisition de données si celles-ci ne sont pas prêtes ?
Oui. J’ai de l’expérience dans la mise en œuvre de pipelines d’ingestion de données utilisant le web scraping (BeautifulSoup, Selenium) ou la gestion de jeux de données existants. Nous pouvons définir le schéma de données requis lors de la phase de cadrage.
Que comprend précisément "end-to-end MLOps" ?
C’est le cycle de vie complet : du suivi des expériences et gestion des versions avec MLflow, aux tests automatisés (Pytest), à la construction de l’API, et au déploiement de l’infrastructure stable via CI/CD et Azure.
Ce setup convient-il pour des prédictions en temps réel ou seulement pour du traitement par lots ?
Ma stack (FastAPI & Docker) est conçue pour haute performance et faible latence, ce qui la rend idéale pour des API d’inférence en temps réel. Nous pouvons adapter l’architecture pour répondre à vos exigences spécifiques de vitesse de prédiction.
Pouvez-vous intégrer le système à mon infrastructure cloud existante (par exemple Azure) ?
Oui. Je suis spécialisé dans le déploiement de systèmes ML robustes directement sur Microsoft Azure. Nous assurerons une intégration fluide, en utilisant GitHub Actions pour orchestrer et déployer automatiquement la pipeline.


