Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur IA - Fine-tuning LLM avec LoRA et QLoRA
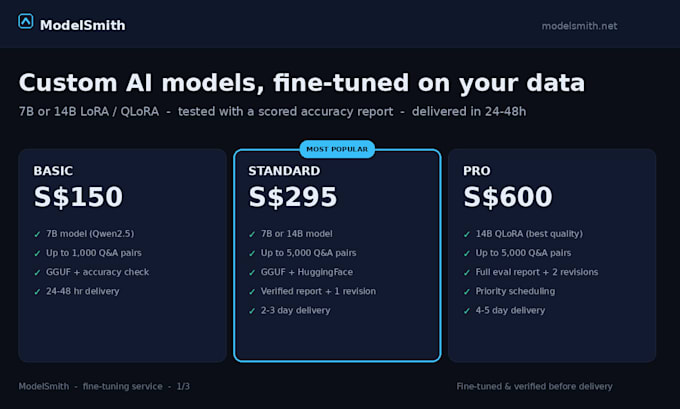
J’effectue un ajustement fin des modèles IA 7B et 14B sur vos données. Pas de modèles de prompts – de véritables LLMs finement ajustés entraînés sur vos questions et réponses, testés avant livraison et livrés au format dont vous avez besoin.
Ce que je fais :
- Ajustement LoRA / QLoRA de modèles 7B ou 14B (Qwen2.5 par défaut)
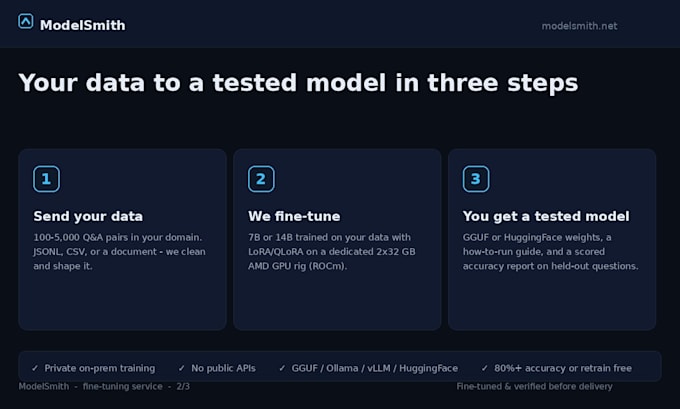
- Entraînés sur 100 à 5 000 de vos paires Q et A
- Vérifié avec un rapport de précision notée sur des questions hors échantillon
- Livré sous forme GGUF (Ollama, llama.cpp) ou HuggingFace (vLLM, Transformers)
Pourquoi c’est différent :
La plupart des gigs d’ajustement fournissent un fichier et disent bonne chance. Je teste d’abord. Chaque modèle est livré avec un rapport de précision sur vos données hors échantillon – 80 % ou plus, ou je retravaille gratuitement.
Confidentialité :
Les entraînements s’effectuent sur une station privée 2x32 Go. Vos données ne partent jamais vers une API publique et sont supprimées à la livraison, sauf si vous me demandez de les conserver.
Vitesse :
Un LoRA 7B s’entraîne en moins d’une heure de calcul. La plupart des projets livrent en 24 à 48 heures.
Envoyez-moi votre jeu de données et j’aurai un modèle testé prêt en quelques jours.


Langage de programmation:
Python
•
PyTorch
•
Autres
Type de données:
Texte
•
Données tabulaires
•
Autres
Moteur d'IA:
LLaMa
•
PyTorch
•
Autres
Traduction automatique
Quel modèle utilisez-vous ?
Qwen2.5-7B-Instruct par défaut pour le niveau 7B. Qwen2.5-14B-Instruct pour 14B. Modèles Mistral et Llama disponibles sur demande.
Que dois-je vous envoyer ?
100 à 5 000 paires Q et A dans n’importe quel format : JSONL, CSV, ou même un document. Je les nettoie et les structure.
En quoi cela diffère-t-il d’un modèle de prompt ou d’un système prompt ?
Un modèle de prompt dirige un modèle générique. Un ajustement fin modifie les poids du modèle afin qu’il connaisse vos réponses de manière native. Meilleure précision, votre voix, moindre surcharge de prompts.
Mes données sont-elles en sécurité ?
Oui. L’entraînement s’effectue sur une station locale privée 2x32 Go, pas sur une API publique. Je supprime le jeu de données à la livraison sauf si vous demandez de le conserver.
Qu'est-ce que je reçois exactement ?
Les poids du modèle (GGUF et/ou HuggingFace), un guide de démarrage avec les commandes exactes pour votre runtime (Ollama, llama.cpp, vLLM), et un rapport de précision noté.
Et si le modèle ne fonctionne pas bien ?
L’offre standard inclut 1 révision gratuite, l’offre Premium 2. Si l’évaluation hors échantillon ne atteint pas votre objectif de précision, je retravaille sans frais.
Combien de temps prend la livraison?
7B : 24-48 heures. 14B : 2-5 jours. Le délai commence dès que votre jeu de données est confirmé.
Ai-je besoin de mon propre GPU ou matériel ?
Non. Je gère tout l’entraînement sur mon matériel. Vous n’avez besoin que du matériel pour exécuter le modèle final (n’importe quel CPU peut faire fonctionner un GGUF 7B, ou utiliser Ollama).