Je vais construire des web scrapers Python personnalisés et automatiser l'extraction de données
A
A
Albert P
Certaines informations ont été traduites automatiquement.
Plein écran
À propos de ce service
Traduction automatique
Besoin d’un flux de données fiable et automatisé pour rationaliser vos opérations ? Je peux vous aider !
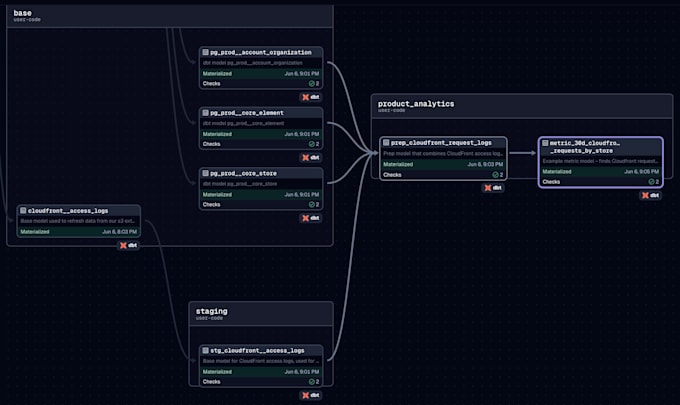
Je suis un ingénieur de données professionnel expérimenté dans la construction de pipelines ETL/ELT de niveau production, d’intégrations API et de solutions d’automatisation des données utilisant Python, SQL et les technologies cloud.
Ce que je peux faire pour vous :
ETL/ELT Pipelines : extraire, transformer et charger les données à partir d’API, de bases de données, de fichiers et de stockages cloud.
Intégrations API : connecter des services tiers et automatiser les transferts de données.
Automatisation des données : créer des flux de travail planifiés, une synchronisation des données et des pipelines pilotés par les événements.
Web Scraping : collecter et traiter des données à partir de sites web et d’autres sources en ligne.
Cloud Data Engineering : concevoir des solutions avec AWS, S3, Redshift et d’autres services cloud.
Transformation des données : nettoyer, valider et transformer des données brutes en utilisant Python, SQL et dbt.
Monitoring & Reliability : mettre en place la journalisation, la gestion des erreurs, les mécanismes de retry et les notifications.
Intégration IA : intégrer les LLM et le traitement piloté par l’IA dans vos flux de données.
Technologies avec lesquelles je travaille :
Python, SQL, PostgreSQL, AWS, Redshift, dbt, Dagster, Apache Airflow, REST APIs, Docker et plus encore.
Pourquoi travailler avec moi ?
J’ai une expérience pratique dans le développement de données en production.
Outils et cadres de modèles d'IA
LangChain
n8n
Google Gemini
Plateforme
Discord
CRM HubSpot
Slack
Telegram
Type
Synchronisation de data
Automation d'e-mails
Automatisation des tâches
Web scraping
Web Scraping et saisie de données
Points d'intégration d'automatisations
Site Internet
Google Sheets
Slack
E-mail
Langage de programmation
Bash
JavaScript
Python
Dactylographiés
HTML et CSS
Découvrez Albert P
Albert P
Data Engineer III
DePhilippines
Membre depuisnov. 2026
Langues
Tagalog, Anglais
I am a Data Engineer with extensive experience in building LLM-powered research pipelines and migrating legacy fraud detection systems to modern stacks like dbt and Dagster. I specialize in developing config-driven delivery frameworks and optimizing high-volume data pipelines across AWS, Snowflake, and Redshift environments.