Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Analyste de données, expert Power BI, spécialiste des tableaux de bord Excel
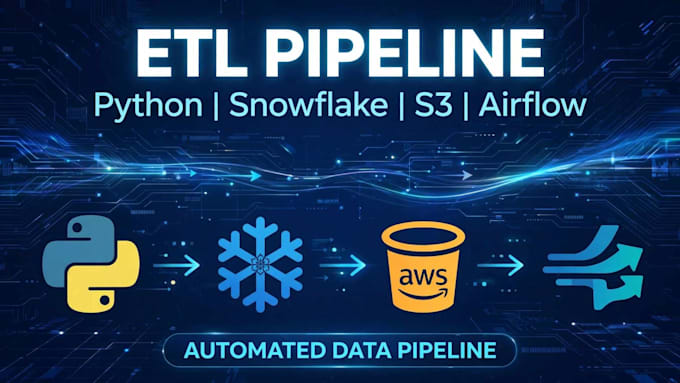
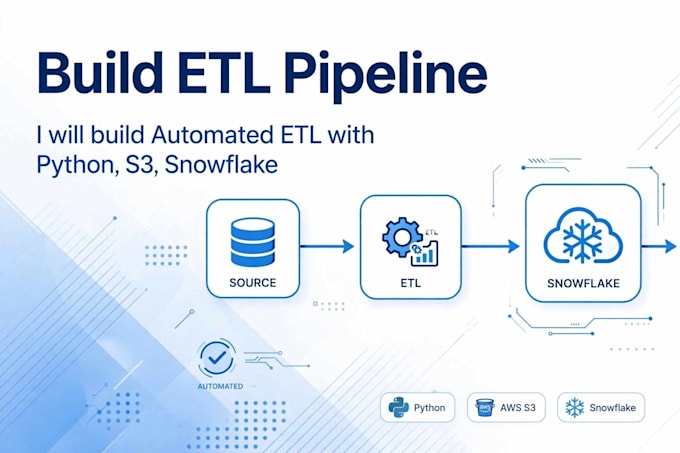
Marre de la gestion manuelle des données ? Je mettrai en place un pipeline ETL entièrement automatisé avec Python, Snowflake et S3 pour vous.
Ne perdez plus de temps. Je concevrai un pipeline de données robuste, évolutif et prêt pour la production qui extrait les données de plusieurs sources, les transforme et les charge automatiquement dans votre Data Warehouse.
CE QUE VOUS OBTIENDREZ :
Pipeline ETL personnalisé (Python / PySpark)
Extraction des données depuis - API, CSV, JSON, S3, bases de données
S3 comme couche de staging / Data Lake
Transformation et nettoyage des données
Chargement vers Snowflake (optimisé pour les performances)
Orchestration avec Apache Airflow
Vérifications de qualité des données et gestion des erreurs
Documentation et guide de déploiement
STACK TECHNOLOGIQUE UTILISÉ :
Python, PySpark, Snowflake, AWS S3, Airflow, AWS Glue, SQL, Pandas
POURQUOI MOI ?
Code propre et optimisé
Pipeline prêt pour la production, pas seulement un script
Livraison dans les délais
100 % de support après livraison
FORFAITS :
Basique : 1 source ETL
Standard : 3 sources + Airflow (LE PLUS VENDU)
Premium : End-to-End 5 sources + déploiement
Vous avez une exigence personnalisée ? Envoyez-moi un message avant de commander. Automatisons vos données !
Mots-clés : ingénierie des données, pipeline ETL, python ETL, snowflake, aws s3, airflow, pyspark, data warehouse
Destination Platform:
Snowflake
•
mySQL
•
Amazon S3
Outils et plateformes:
Autres
Traduction automatique
De quoi avez-vous besoin pour commencer ?
Fichier source/API, détails S3 et Snowflake et votre logique.
Fournirez-vous la documentation ?
Oui, tous les packages incluent la documentation.
Pouvez-vous traiter d'autres bases de données ?
Oui, je peux travailler avec BigQuery, Redshift, Postgres, MySQL, APIs.