Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur logiciel senior solutions POS, ERP et web mobile alimentées par l’IA
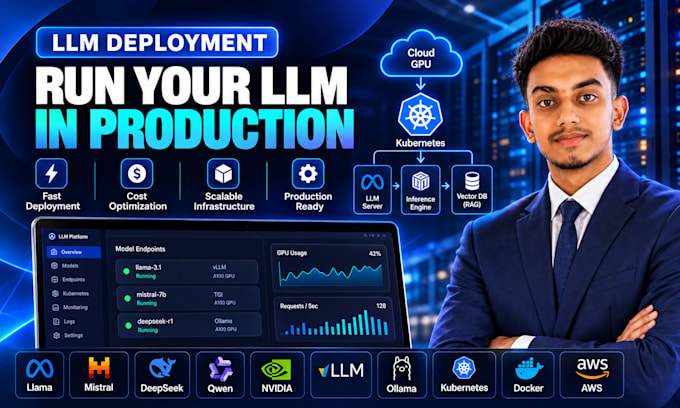
Vous avez besoin que votre LLM soit déployé en production rapidement, de manière optimisée et économique ?
Vous êtes au bon endroit !
Je déploie et configure des LLM open-source sur des serveurs cloud GPU et Kubernetes, avec des moteurs d'inférence ajustés pour des réponses rapides et des coûts GPU réduits.
Ce que je propose :
Pile technologique :
Inference : vLLM || TGI || Ollama || NVIDIA Triton || TensorRT-LLM || llama.cpp || SGLang
Modèles : Hugging Face || Llama || Mistral || Qwen || DeepSeek
Cloud & GPU : AWS || Google Cloud || Azure || RunPod || Lambda Labs
Conteneurs : Docker || Kubernetes || Helm
Monitoring : Prometheus || Grafana
Pourquoi me choisir ?
Faisons en sorte que votre LLM soit en ligne dès aujourd'hui !
Traduction automatique
Quels LLM pouvez-vous déployer ?
Tout modèle open-source de Hugging Face, y compris Llama, Mistral, Qwen, DeepSeek, Gemma, et Phi, ainsi que des modèles fine-tuned ou personnalisés que vous fournissez.
Que comprend la configuration du moteur d'inférence ?
Configuration et ajustement de vLLM, TGI, Triton, ou Ollama pour votre modèle : mémoire GPU, batching, longueur de contexte, cache KV, parallélisme tensoriel, et quantification, pour des réponses plus rapides à moindre coût.
Quel moteur d'inférence devrais-je utiliser ?
vLLM pour des API à haut débit, TGI pour les modèles Hugging Face, Triton ou TensorRT-LLM pour la performance maximale sur GPU NVIDIA, et Ollama ou llama.cpp pour des configurations plus petites ou CPU. Je vous recommanderai la meilleure option.
Pouvez-vous réduire mes coûts GPU ?
Oui. Grâce à la quantification (AWQ, GPTQ, GGUF), au batching, et à l'ajustement des GPU, je peux souvent faire fonctionner le même modèle sur du matériel moins cher avec une qualité similaire.
L'API sera-t-elle comme celle d'OpenAI ?
Oui. Je peux mettre en place une API compatible OpenAI, pour que vous puissiez passer de votre app existante OpenAI à votre propre LLM en changeant simplement l'URL de base et la clé API.
Qui paie les coûts GPU et cloud ?
Les coûts GPU et d'hébergement sont facturés par le fournisseur (AWS, GCP, Azure, RunPod, etc.) à votre propre compte. Je vous aiderai à choisir le GPU le plus rentable pour votre modèle et votre trafic.
Mon modèle et mes données sont-ils privés ?
Oui. Votre LLM fonctionne sur vos propres serveurs, donc les prompts et données ne partent jamais vers des APIs tierces. Je sécurise également le point d'accès avec des clés API, SSL, et règles de pare-feu. Je peux signer un NDA si nécessaire.
Que dois-je fournir avant de commencer ?
Le modèle que vous souhaitez (ou vos exigences), accès à votre cloud ou compte GPU, trafic attendu, et tout domaine que vous souhaitez utiliser. Si vous n'êtes pas sûr, je propose une consultation gratuite.
Pouvez-vous déployer un modèle que j'ai fine-tuned ?
Oui. Partagez vos poids de modèle ou votre repo Hugging Face, et je le déploierai et l'optimiserai avec le moteur d'inférence adapté.
Vous ne savez pas quel package correspond à votre projet ?
Contactez-moi avant de commander. Je vais examiner vos besoins en modèle et trafic, et recommander le package adapté ou vous envoyer une offre personnalisée.
