Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Level 2


Traduction automatique
Affinement personnalisé de LLM
Les modèles d'IA génériques peuvent halluciner ou échouer dans vos flux de travail. Affinez-les avec vos données propriétaires, formats et connaissances du domaine.
Livrables & rapidité
LA SOLUTION
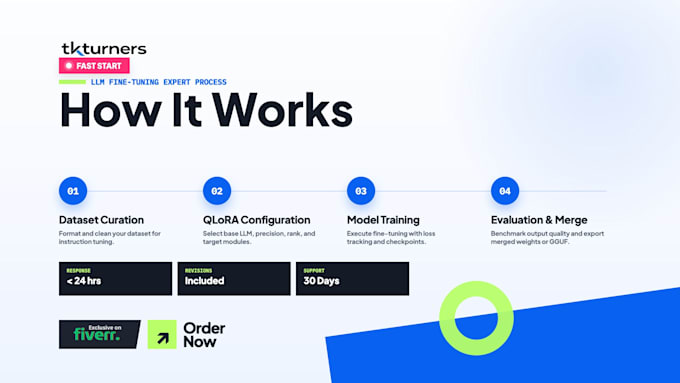
Nous construisons des datasets d'instructions propres, optimisons les paramètres rank/alpha et affinons les modèles pour de meilleures performances dans le domaine et des coûts d'inférence réduits.
POURQUOI TKTURNERS
Ingénieurs IA full-stack fournissant des modèles prêts pour la production et automatisation des workflows adaptés à vos besoins commerciaux.
GARANTIE DE QUALITÉ
Chaque modèle est évalué avec des prompts de test convenus. Si les résultats ne répondent pas aux métriques cibles, nous le réentraînons sans coût supplémentaire.
AUDIT IA GRATUIT
Contactez-nous avant de commander pour un audit gratuit de 15 minutes de votre dataset et une recommandation d'architecture de modèle.
Senior Software Engineer
Level 2
Langues
Traduction automatique
Traduction automatique
Pourquoi devrais-je vous envoyer un message avant de commander ?
Contacter avant permet d’évaluer la taille de votre dataset, de vérifier la compatibilité avec le modèle de base (par exemple, Llama 3, Mistral) et de confirmer les besoins en calcul pour vous proposer le package adapté.
Quelles architectures de LLM de base supportez-vous pour l’affinement ?
Nous supportons Llama 3/3.1, Mistral, Mixtral, Gemma 2, Qwen 2.5, DeepSeek, Falcon, ainsi que tout modèle open-weights personnalisé hébergé sur Hugging Face.
Quelle est la différence entre LoRA et QLoRA ?
LoRA entraîne des matrices d’adaptateurs à faible rang pour adapter efficacement un modèle. QLoRA quantifie le modèle de base à 4 bits pendant l’entraînement, réduisant considérablement les besoins en VRAM GPU tout en conservant une précision maximale.
Qui couvre les coûts de calcul GPU et d’infrastructure cloud ?
Les coûts de calcul (RunPod, Lambda Labs, Google Colab Pro ou Hugging Face Inference Endpoints) sont payés directement par le client. Nous vous guidons pour la configuration GPU la plus économique.
Dans quel format dois-je fournir mon dataset ?
Vous pouvez fournir vos données en JSON, JSONL, CSV ou texte brut. Nous les nettoyons, validons et convertissons en formats d’instructions standard comme Alpaca, ShareGPT ou ChatML.
Quels livrables précis vais-je recevoir à la fin du projet ?
Vous recevrez les poids de l’adaptateur LoRA entraînés, le modèle autonome fusionné (si demandé), les fichiers GGUF quantifiés pour Ollama/LM Studio, les scripts de test et les métriques d’évaluation.
Pouvez-vous déployer le modèle affiné sur une API ou un cloud privé ?
Oui. Nous pouvons déployer votre modèle entraîné sur Hugging Face Dedicated Endpoints, RunPod serverless, vLLM, Ollama ou un backend FastAPI personnalisé sur AWS/GCP.
De quel accès API ou plateforme tierce aurez-vous besoin ?
Nous pourrions avoir besoin d’un accès en lecture/écriture à votre compte Hugging Face (jeton d’accès) et à votre plateforme cloud GPU choisie (RunPod, Lambda Labs ou AWS) via des clés API ou des identifiants temporaires.
Comment gérez-vous les révisions et la performance de référence ?
Chaque niveau inclut des révisions pour ajuster les taux d’apprentissage, les epochs ou les paramètres rank/alpha. Nous évaluons votre modèle avec des ensembles de validation pour vérifier la qualité.
Offrez-vous une assistance et une maintenance après livraison ?
Oui, nous proposons une maintenance continue et un support en retainer pour l’ingestion périodique de datasets, le réentraînement des modèles et la montée en charge de l’inférence cloud.