Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Level 2
Traduction automatique
Données synthétiques AI & benchmarking de modèles
LE PROBLÈME
De mauvaises données d'entraînement peuvent provoquer des hallucinations, des résultats incohérents et des problèmes coûteux en production. La labellisation manuelle de données de niche est lente et coûteuse.
LA SOLUTION
Nous créons des jeux de données synthétiques prêtes pour la production avec des cas limites réalistes et des pipelines d’évaluation automatisés pour tester la précision, la latence et la fiabilité des modèles.
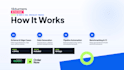
CE QUE NOUS LIVRONS
POURQUOI CHOISIR TKTURNERS
Ingénierie AI spécialisée axée sur des jeux de données de haute qualité, une génération structurée et une évaluation fiable des modèles.
LIVRAISON RAPIDE
Obtenez des jeux de données validés et des pipelines de benchmark prêts pour l’ajustement fin ou l’évaluation en production.
REVUE DE DONNÉES GRATUITE
Contactez-nous avant de commander pour une revue gratuite de votre stratégie de données & schéma.
Senior Software Engineer
Level 2
Langues
Traduction automatique
Traduction automatique
Pourquoi devrais-je vous envoyer un message avant de commander ?
Une prise de contact préalable nous permet de revoir votre schéma de données, vos exigences de domaine et vos cibles d’évaluation afin de choisir le bon package et d’éviter les retards de livraison.
Qu’est-ce que les données d’entraînement synthétiques et comment sont-elles utilisées ?
Les données d’entraînement synthétiques sont des données générées artificiellement qui imitent les distributions du monde réel. Elles permettent d’ajuster finement et de tester des modèles AI sans risques pour la vie privée ni coûts de labellisation manuelle.
Quels formats de données supportez-vous ?
Nous livrons les données en formats JSONL, CSV, Parquet, JSON et formats de jeux de données standard Hugging Face optimisés pour l’ajustement fin des modèles OpenAI, Anthropic ou open-source.
Comment garantissez-vous la haute qualité des données synthétiques ?
Nous utilisons des contraintes de schéma, la déduplication sémantique, des vérifications de distribution statistique et des règles de validation automatisées pour éliminer hallucinations et erreurs de formatage.
Que comprend le pipeline d’évaluation des modèles ?
Le pipeline inclut des tests automatisés de benchmark, le scoring de précision, le suivi de latence, l’évaluation par LLM comme juge, et des rapports de tests de régression.
Les coûts d’utilisation de l’API et des modèles tiers sont-ils inclus ?
Non, les coûts d’utilisation de l’API (OpenAI, Anthropic ou cloud) sont facturés directement sur votre compte. Nous aidons à la configuration clé et à l’optimisation du budget.
De quelles informations ou accès avez-vous besoin pour commencer ?
Nous avons besoin de votre schéma cible, d’exemples de données (si disponibles), des règles du domaine métier et des critères ou métriques d’évaluation que vous souhaitez benchmarker.
Comment vos données d’entreprise confidentielles sont-elles protégées ?
Nous signons des accords de non-divulgation standard, ne stockons jamais vos données sensibles de façon permanente, et générons des jeux de données entièrement anonymisés et conformes à la vie privée.
Comment fonctionnent les révisions pour la génération de jeux de données ?
Les révisions incluent l’ajustement de la distribution des jeux de données, la modification des cas limites, l’affinement des modèles de prompts ou la relance de métriques d’évaluation spécifiques.
Proposez-vous une maintenance continue du pipeline ?
Oui, nous proposons une maintenance continue et une expansion des jeux de données via des jalons personnalisés ou des forfaits de support mensuels.


