Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Je vais héberger votre LLM en privé sur votre propre serveur ou cloud
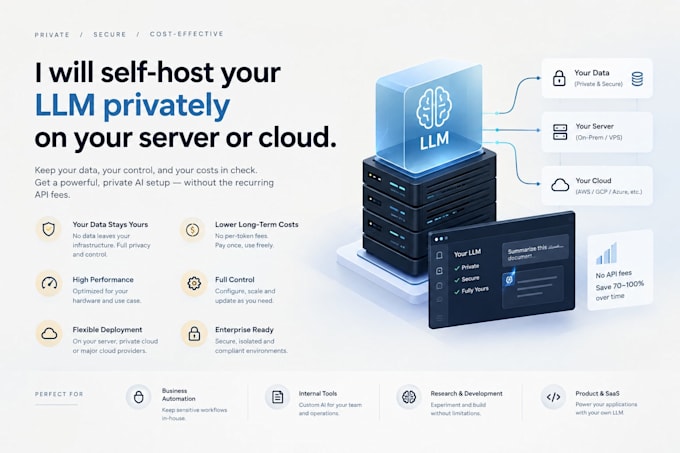
Faire fonctionner votre LLM via une API tierce signifie que vos prompts et données transitent par les serveurs de quelqu'un d'autre. Si vous avez besoin de confidentialité des données, de coûts prévisibles ou d'un modèle hors ligne / isolé, l'auto-hébergement est la solution. Je le configure de bout en bout.
Je déploie des modèles à poids ouverts (Llama, Mistral, Qwen, DeepSeek, ou votre modèle personnalisé) sur votre VPS, serveur dédié ou instance GPU cloud (AWS, Vultr, RunPod, Lambda Labs), et les expose via un endpoint API compatible OpenAI que vous pouvez intégrer directement dans votre application.
Ce que vous obtenez :
J'ai mis en place une infrastructure de production sur AWS (ECS, EC2, IAM) et géré des charges de travail Kubernetes avec GPU auparavant, ce n'est pas mon premier serveur.
AI Engineer and Automation Specialist I LangChain, RAG I React, Node, DevOps
Langues
Traduction automatique
Traduction automatique
Ai-je besoin de ma propre GPU ?
Non — je peux vous aider à provisionner une instance GPU cloud si vous n'en avez pas (le coût est séparé du prix du service).
Pouvez-vous faire du fine-tuning du modèle ?
C'est un service séparé — ce service couvre le déploiement / hébergement d'un modèle existant ou à poids ouverts.
Mes données sont-elles vraiment privées ?
Oui — une fois déployé, toutes les inférences s'effectuent sur votre infrastructure ; rien n'est envoyé à une API tierce.
