Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Python, ingénierie des données, APIs et automatisation IA
Vous avez besoin d’un pipeline de données fiable capable de gérer des charges de travail en production ?
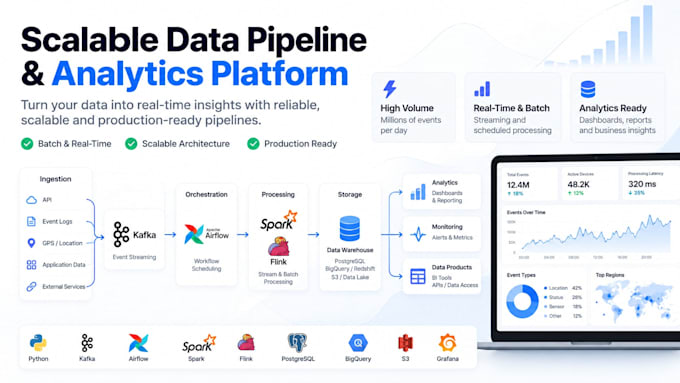
Je vais créer des pipelines de données évolutifs et faciles à maintenir pour le traitement par lots ou en temps réel en utilisant des technologies telles que Python, Airflow, Kafka, Spark, SQL, PostgreSQL, AWS et GCP
Je peux vous aider avec :
Je possède plus de 10 ans d’expérience en ingénierie logicielle dans les domaines Backend, Data Engineering, Cloud et DevOps, y compris des systèmes à haut volume traitant de grands ensembles de données et des centaines de milliers d’événements par jour.
Vous recevrez un code propre, facile à maintenir, une documentation claire et une solution adaptée à vos besoins réels.
Vous avez une pipeline complexe ou un problème en production ?
Contactez-moi avant de commander et je vous aiderai à choisir la bonne architecture et le bon package.