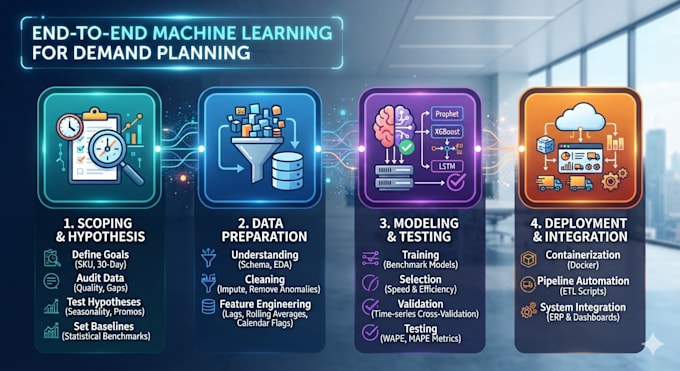
1. Définition du périmètre et hypothèses
- Définir les objectifs : Fixer l'horizon de prédiction (par exemple, 30 jours au niveau SKU) et les indicateurs cibles (par exemple, réduire les ruptures de stock).
- Audit des données : Vérifier la profondeur, la qualité et les lacunes des logs de ventes et d'inventaire historiques.
- Tester les hypothèses : Vérifier les tendances saisonnières et confirmer si les promotions ou la météo influencent statistiquement la demande.
- Établir des références : Mettre en place une référence statistique simple pour mesurer la performance du ML.
2. Préparation des données
- Compréhension : Analyser les schémas, identifier les relations entre les données et réaliser une analyse exploratoire (EDA).
- Nettoyage : Imputer les timestamps manquants, lisser les anomalies de la chaîne d'approvisionnement et standardiser les formats.
- Création de caractéristiques : Créer des variables de retard, des moyennes mobiles, des indicateurs calendaire et des signaux de prix/promotion.
3. Modélisation et test
- Entraînement : Évaluer des modèles statistiques (Prophet), basés sur des arbres (XGBoost/LightGBM) et de deep learning (LSTM).
- Sélection : Analyser la vitesse d'entraînement et l'efficacité des ressources système.
- Validation : Effectuer une validation croisée sur séries temporelles pour ajuster les hyperparamètres sans fuite de données futures.
- Test : Évaluer le modèle final sur un ensemble de test non vu en utilisant des métriques d'erreur comme WAPE et MAPE.
Ce module est à empaqueter [Pas de déploiement/intégration]