Je vais construire des modèles d'apprentissage automatique, de clustering et de prédiction

Certaines informations ont été traduites automatiquement.

Turquie

Je parle Anglais, Espagnol, Allemand
Bonjour ! Je suis un statisticien professionnel et analyste de données avec une solide formation en mathématiques et une expérience pratique approfondie en R, Python, SPSS et SQL. Je me spécialise dan...
À propos de ce service

Vous avez besoin d'intelligence prédictive ou d'algorithmes de clustering automatisés basés sur vos données ?

Je développe des pipelines d'apprentissage automatique robustes et sans fuite, adaptés à la classification, la régression et la segmentation de clients/données en utilisant Python (Scikit-Learn, XGBoost) et R.

Services proposés :

  • Apprentissage supervisé : régression linéaire/logistique, forêt aléatoire, SVM, gradient boosting, XGBoost
  • Apprentissage non supervisé : K-Means, clustering hiérarchique, DBSCAN, PCA
  • Prévision de séries temporelles et analyse de tendances
  • Ingénierie des caractéristiques, imputation et détection des valeurs aberrantes
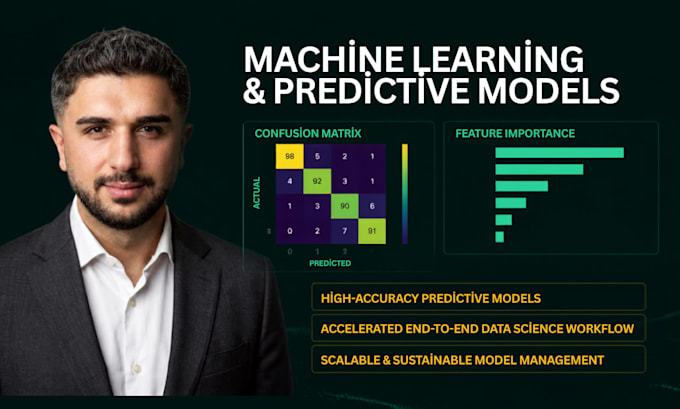
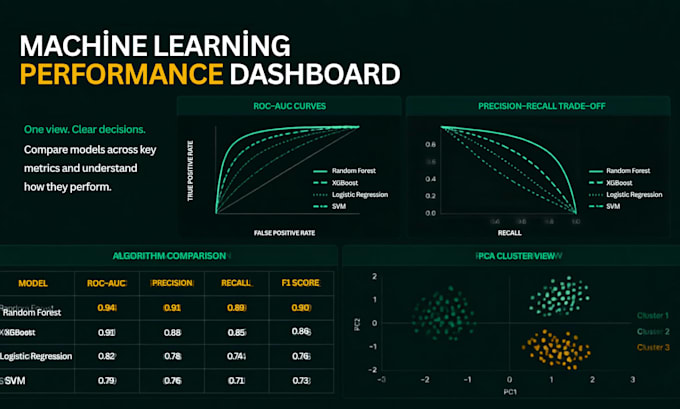
  • Évaluation complète : ROC-AUC, précision/rappel, RMSE, matrice de confusion

Ce que vous recevrez :

  • Notebook Jupyter bien documenté ou script R
  • Fichiers de modèles sérialisés prêts pour la production (.pkl, .joblib, .rds)
  • Graphiques d'évaluation du modèle et décompositions des métriques

Envoyez un message avec votre brief de projet et votre dataset pour une première évaluation de faisabilité
Expertise:

Apprentissage des fonctionnalités

•

Classification

Langage de programmation:

Python

•

R

•

MATLAB

•

SQL

Frameworks:

DeepPy

APIs:

Google Cloud Vision API

Outils:

Stata