Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Développeur web full stack : WordPress, OCR, intégration d’API, sites web sur les peptides
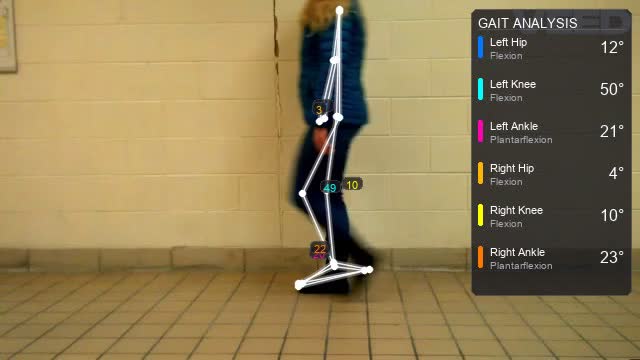
Vous avez besoin d'automatiser le suivi visuel, d'extraire des données ou de lancer une application d'IA ?
L'analyse manuelle de vidéos et la gestion de documents coûtent du temps à votre entreprise. Je conçois des systèmes d'IA de vision par ordinateur et OCR performants pour résoudre vos blocages et transformer les données visuelles en insights exploitables.
Que vous ayez besoin d'une application de vision par ordinateur ou de détection d'objets autonome ou d'un pipeline d'extraction de données, je fournis des logiciels robustes, prêts à déployer, adaptés à votre flux de travail.
PROBLÈMES QUE JE RÈGLE :
TECH STACKS & OUTILS :
POURQUOI CHOISIR CE SERVICE ?
Contactez-moi avant de commander pour discuter de votre dataset !
Traduction automatique
Que dois-je fournir pour commencer à créer mon application de vision par ordinateur ou de détection d'objets ?
Veuillez fournir votre dataset (images, vidéos ou scans de documents) ainsi qu'une explication claire des objets ou textes que vous souhaitez que le système d'IA de vision par ordinateur et OCR suive ou extraye. Si vous n'avez pas encore de données, je peux vous aider à la collecte et à la configuration de frameworks personnalisés.
Quels frameworks et modèles de deep learning utilisez-vous pour le développement ?
Je rédige principalement des scripts Python d'IA propres utilisant OpenCV pour les flux vidéo en temps réel, ainsi que PyTorch et TensorFlow pour l'entraînement des modèles. Pour une précision à haute vitesse, j'emploie des architectures de pointe comme YOLOv8 et YOLOv11 pour garantir des résultats de qualité.
Votre système OCR peut-il gérer l'écriture manuscrite ou des documents complexes ?
Oui, le système OCR intelligent est configuré avec des moteurs robustes (comme Tesseract, EasyOCR ou APIs de vision cloud) adaptés à la lecture de mises en page multi-colonnes, factures numériques et champs de texte complexes, transformant les fichiers bruts en pipelines de données structurées et consultables.
L'application finale fonctionnera-t-elle localement ou pourra-t-elle être déployée dans le cloud ?
Les deux ! Selon vos besoins, je peux livrer votre solution en tant qu'outil léger pour bureau, la packager dans des conteneurs Docker pour serveurs cloud (AWS/GCP), ou créer une interface d'application web IA entièrement interactive avec des outils modernes de tableau de bord Python comme Streamlit.
Comment garantissez-vous la précision du suivi d'objets et de la segmentation d'images ?
Chaque pipeline subit des tests de validation stricts utilisant des métriques d'évaluation de machine learning personnalisées. Je règle rigoureusement les seuils de confiance, élimine les faux positifs et affine les masques de segmentation d'image jusqu'à ce que le système atteigne la précision requise en production.