Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en vision par ordinateur
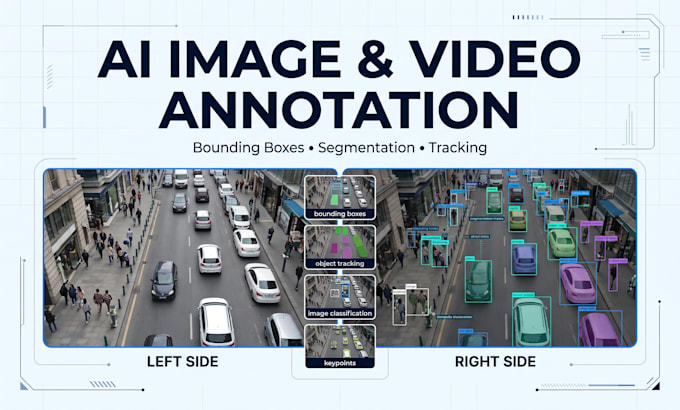
Vous avez besoin d’annotations précises et cohérentes pour vos images ou vidéos dans le cadre de votre projet d’IA ou de vision par ordinateur ?
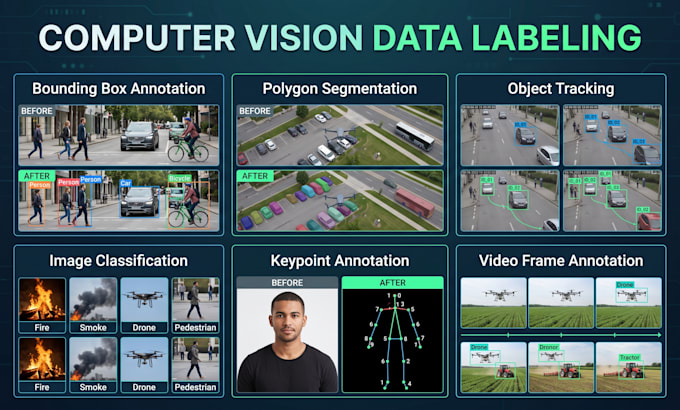
Je peux vous aider à préparer des données d’entraînement propres et structurées pour la détection d’objets, la segmentation, la classification et les applications de vision par ordinateur.
J’ai une expérience pratique avec les jeux de données d’images, l’augmentation de données, l’annotation et la préparation de datasets.
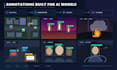
Ce que je peux annoter
Boîtes englobantes
Annotations polygonales
Segmentation d’objets
Annotation de frames vidéo
Tâches d’annotation personnalisées
Datasets pour IA et apprentissage automatique
Formats de sortie
Selon vos besoins, je peux préparer des annotations pour des formats tels que :
YOLO
COCO
Pascal VOC / XML
JSON
CSV
TXT
Masques de segmentation
Outils
Je peux travailler avec :
Roboflow
CVAT
LabelImg
Kaggle
Python
Plateforme d’annotation fournie par le client
Pourquoi travailler avec moi ?
Je comprends l’annotation du point de vue de la vision par ordinateur et de l’apprentissage automatique, pas seulement comme une tâche de labellisation.
Je me concentre sur :
Une labellisation cohérente
Le respect de vos directives d’annotation
Une structure claire du dataset
Une vérification minutieuse de la qualité
Une attribution correcte des classes
Veuillez me contacter avant de commander si votre dataset est volumineux, complexe ou nécessite un format d’annotation spécifique. Je peux examiner un échantillon et vous fournir une offre personnalisée.

Technique:
Manuel
Type d'identification:
Texte
•
Image
•
Vidéo