Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Je crée des modèles LoRA personnalisés qui reproduisent de manière fiable un personnage, un produit ou un style spécifique, et je construis des workflows ComfyUI qui les transforment en images et vidéos cohérentes.
Processus complet : dataset, captioning, entraînement et régularisation, pour que le modèle reste précis sans déborder sur des générations non liées.
Pas de dataset ? Je peux en créer un à partir de vos photos ou vidéos brutes, ou générer un ensemble synthétique original pour de nouveaux personnages et styles.
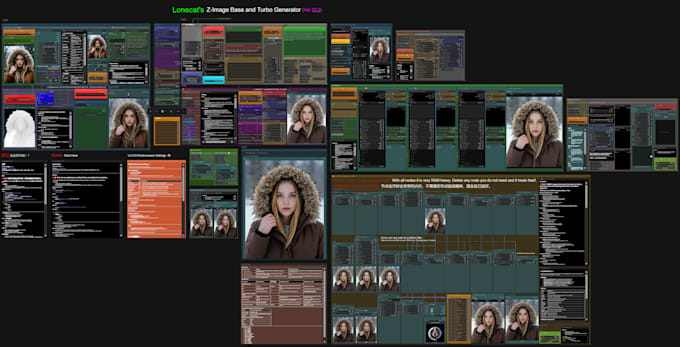
Workflows conçus autour de votre LoRA :
- img2img : retoucher et modifier des images
- img2vid : animer votre personnage ou produit
- ref2vid : vidéo à partir de vos images de référence
- première/dernière image en vidéo : plans entre deux images clés
- Autre chose : décrivez la tâche, je vous dirai si c’est réalisable
Modèles : SDXL et FLUX.2 [klein] 4B, tous deux autorisent l’usage commercial. Uniquement des images dont vous détenez les droits ; personnes réelles uniquement avec leur consentement.
Chaque LoRA est testé sur de nouvelles scènes et prompts, pas seulement sur les photos d’entraînement.
Premium : le workflow plus un script d’installation en un clic. Si quelque chose ne fonctionne pas, je vous guiderai lors d’un appel (Windows + NVIDIA).
Envoyez vos références et objectifs, je vous dirai honnêtement ce qui est réaliste avant de passer commande.
Veuillez informer le freelance de toute préférence ou préoccupation concernant l'utilisation d'outils d'IA dans la réalisation et/ou la livraison de votre commande.
Generative AI Specialist, ComfyUI and LoRA Training
Langues
Traduction automatique
Traduction automatique
Quelles images dois-je fournir ?
Pour une personne, un personnage ou un objet — au moins 15-20 photos claires, haute résolution, prises sous différents angles, avec différentes lumières et arrière-plans. Pour un style — environ 30-50 images d’exemple. Plus la variété de vos photos est grande, plus le LoRA sera flexible et fiable.
Sur quelle plateforme pourrai-je utiliser le LoRA ?
Vous recevrez un fichier .safetensors standard qui fonctionne dans ComfyUI, Automatic1111, et la plupart des autres outils Stable Diffusion / FLUX. Si vous avez besoin d’aide pour le configurer, le package Premium inclut un workflow ComfyUI prêt à l’emploi.
Combien de temps dure la formation en général ?
La formation elle-même prend généralement entre 1 et 3 heures selon le modèle. La majorité du temps de livraison est consacrée à la préparation du dataset, au captioning et à la génération de résultats d’échantillons propres — pas à l’exécution de la formation elle-même.
Le LoRA fonctionnera-t-il dans des scènes différentes de mes photos d’entraînement ?
Oui, c’est l’objectif. Je teste chaque LoRA avec des prompts décrivant de nouveaux environnements, éclairages et actions que vos photos d’entraînement n’incluent pas, pour m’assurer qu’il généralise plutôt que de simplement répéter les images d’entraînement.
Puis-je utiliser le LoRA à des fins commerciales ?
Oui. Je forme sur des modèles de base sous licence Apache 2.0 (SDXL, FLUX.2 Klein), donc il n’y a aucune restriction sur l’utilisation commerciale de ce que vous générez.
Et si le premier résultat ne correspond pas à ce que j’attendais ?
C’est là que les révisions interviennent — incluses dans chaque package. Envoyez-moi un retour précis (ce qui ne va pas, quel échantillon) et je réentraînerai ou ajusterai en conséquence.