Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données
Des requêtes lentes, des exports CSV manuels ou des pipelines de données défectueux freinent-ils votre activité ?
Je suis un ingénieur de données professionnel spécialisé dans la création de pipelines ETL/ELT robustes et automatisés ainsi que dans les architectures cloud modernes utilisant Python, SQL, dbt et Dagster.
Services que je propose :
Ingestion automatisée : Extraction de données via API REST, webhooks ou plateformes tierces directement dans votre entrepôt en utilisant Python et dlt.
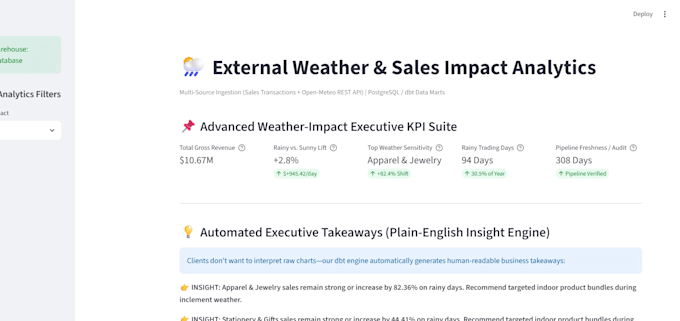
Transformations et modélisation : Construction de marts de données dimensionnels modulaires avec dbt Core pour garantir des tables propres et vérifiées pour le reporting BI.
Entrepôts et bases de données : Mise en place, conception de schémas et optimisation des requêtes pour PostgreSQL, ClickHouse, Snowflake et DuckDB.
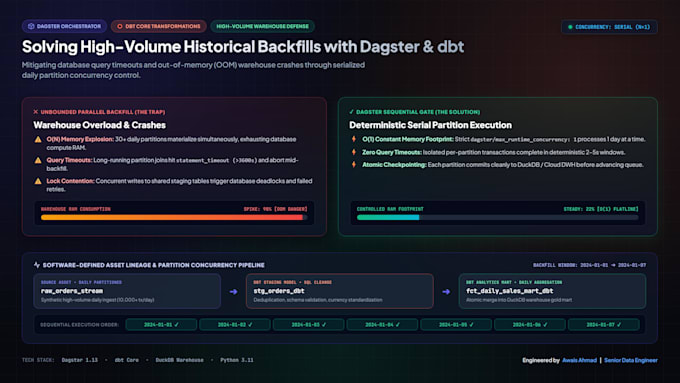
Orchestration de workflows : Programmation, surveillance et automatisation des flux de données avec Dagster ou Airflow, évitant les crashs OOM et les timeout.
Reverse-ETL : Synchronisation des analyses transformées vers votre CRM (par exemple Salesforce, HubSpot).
Pourquoi me choisir ?
Code propre, facile à maintenir, prêt pour la production avec documentation.
Communication rapide et support après livraison.
Veuillez m’envoyer un message avec vos besoins avant de passer commande !

Traduction automatique
De quoi ai-je besoin pour commencer ?
Clés d’accès ou API à vos sources de données, identifiants de base de données, et une brève description de votre résultat attendu ou schéma cible.
Quelles plateformes cloud et bases de données supportez-vous ?
Je me spécialise en PostgreSQL, ClickHouse, Snowflake, DuckDB, Python, dbt Core, Dagster et Docker.
Pouvez-vous déboguer ou optimiser ma pipeline existante ?
Oui ! Si vous rencontrez des performances lentes, des timeout ou des erreurs récurrentes, je peux auditer et résoudre les causes profondes.