Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Développeur backend Python, Django, FastAPI, APIs REST, web scraping
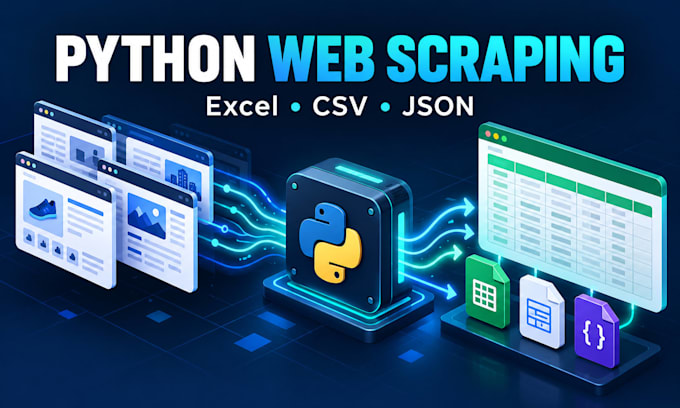
Vous avez besoin de données utilisables pour votre site web plutôt que des heures de copie manuelle ? Je crée des scrapers en Python et fournis des données structurées en CSV, Excel ou JSON.
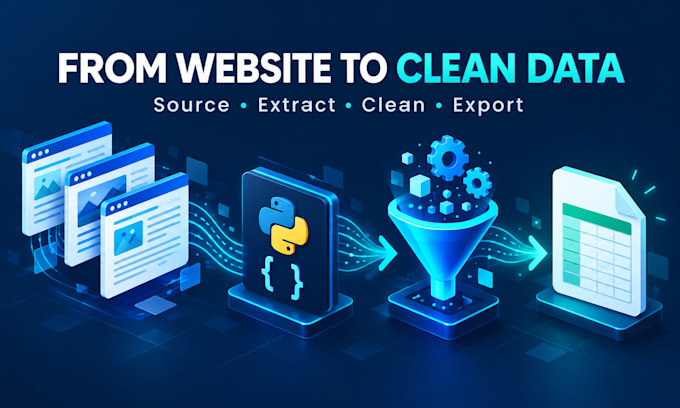
J’utilise BeautifulSoup, requests, Selenium et Playwright. Je peux extraire les champs convenus de produits, de répertoires ou d’autres sites publics, gérer la pagination et le rendu JavaScript, supprimer les doublons et normaliser les colonnes livrées.
BASE : 1 site public statique, jusqu’à 1 000 enregistrements et 100 pages.
STANDARD : jusqu’à 2 sites publics, 5 000 enregistrements et 200 pages au total, y compris le rendu JS.
PREMIUM : jusqu’à 3 sources convenues, 15 000 enregistrements et 500 pages au total, plus un script Python réutilisable et des notes de configuration.
La limite de scope atteinte s’applique. La complexité, les champs et l’accès doivent être convenus avant la commande. La livraison des données de base/standard est incluse dans le Premium. Les révisions corrigent l’extraction convenue, pas de nouveaux sites ou champs.
Veuillez envoyer les URL cibles, les champs requis, un exemple de sortie et le volume estimé avant de commander. Les workflows de connexion autorisés doivent être examinés en premier. Je ne contourne pas les CAPTCHAs ni les restrictions d’accès. Les images de la galerie illustrent le service.
Technologie:
Python
•
sélénium
•
Beautiful Soup
•
Playwright
•
Autres
Technique:
Automatisé(e)
Traduction automatique
Pouvez-vous supprimer des sites Web JavaScript ?
Oui. Les services Standard et Premium peuvent inclure des pages rendues en JavaScript convenues, en utilisant Selenium ou Playwright. Envoyez d'abord les URLs pour que je puisse vérifier la faisabilité et la portée.
Quels formats vais-je recevoir ?
Le CSV ou Excel est inclus ; le JSON est disponible si convenu avant la commande. Partagez les noms de colonnes et un exemple de mise en page pour que les données livrées correspondent à votre flux de travail.
Recevrai-je le code source du scraper ?
Les services Basic et Standard livrent les fichiers de données convenus. Le service Premium inclut également un script Python réutilisable et des notes de configuration. L’hébergement, la planification et la maintenance en continu sont séparés.
Pouvez-vous scraper des pages de connexion ou contourner les CAPTCHAs ?
Je peux évaluer les flux de travail auxquels vous avez accès avec votre permission et les détails d’accès convenus au préalable. Je ne contourne pas les CAPTCHAs ni d’autres restrictions d’accès.
Comment sont gérés les limites et les révisions ?
Les limites de record, de page et de source s’appliquent ensemble ; la première limite atteinte détermine la portée. Les révisions corrigent les champs ou la mise en forme convenus, plutôt que d’ajouter de nouvelles sources ou exigences.