Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Développeur de logiciels
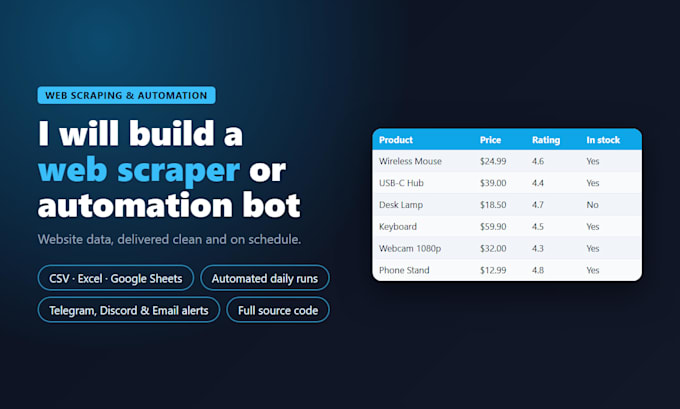
Besoin de données provenant d'un site web, collectées automatiquement ? Je conçois des scrapers et des bots qui le font pour vous.
Ce que vous obtenez :
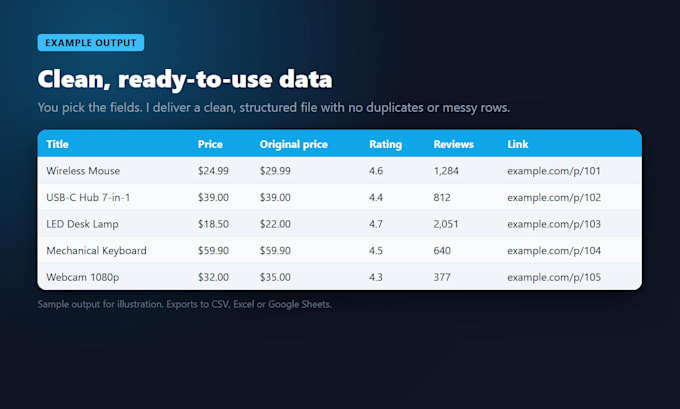
Des données propres au format CSV, Excel ou Google Sheets
Le code source complet dans chaque package
Un guide de configuration simple
Packages :
Basic : collecte unique d'un site web
Standard : récupération automatique selon un planning
Premium : scraping + alertes de changement sur Telegram, Discord ou par email
Fréquence d'exécution (Standard et Premium) : quotidienne par défaut, ou selon l'agenda que vous choisissez (par exemple toutes les 6 heures). Les exécutions très fréquentes sont discutées en premier.
Où cela s'exécute : sur votre propre PC ou sur votre propre compte GitHub (GitHub Actions), vous possédez donc tout. GitHub Actions est soumis aux limites d'utilisation gratuites de GitHub.
Veuillez noter :
Données publiques uniquement. Pas de pages protégées par login, pas de contournement de CAPTCHA ni d'informations personnelles de contact.
Si le site modifie sa mise en page ultérieurement, les corrections font l'objet d'une commande séparée.
À propos : responsable principal de Folia, une application musicale open-source (11,8 K+ étoiles sur GitHub, plus de 2 M de téléchargements). J'ai développé ses connexions avec les services de streaming, qui récupèrent et traitent leurs données.
Envoyez-moi le site web et les données dont vous avez besoin avant de commander, et je vous confirmerai que cela peut être fait.


Technologie:
JavaScript
•
Python
•
NodeJS
•
Marionnettiste
•
Playwright
Technique:
Automatisé(e)
Traduction automatique
Qu’est-ce qui compte comme révision par rapport à la maintenance future ?
Les révisions couvrent des ajustements pendant que nous travaillons sur la commande — par exemple corriger une colonne ou modifier le format de fichier. Une fois la commande marquée comme terminée, si le scraper casse plus tard parce que le site a mis à jour sa mise en page, la réparation nécessitera une nouvelle commande.
Pouvez-vous gratter n'importe quel site Web?
Je ne récupère que des données publiques. Je ne travaille pas sur des sites protégés par login, je contourne pas les CAPTCHAs/les murs anti-bot ni ne collecte des informations de contact personnelles. Si le site propose une API officielle, je l’utiliserai à la place. Envoyez-moi simplement le lien et je jette un œil !
Ai-je besoin de mon propre serveur ?
Non ! Vous pouvez exécuter le script sur votre propre ordinateur, ou l’héberger gratuitement sur Actions GitHub qui s’exécutent dans le cloud même lorsque votre PC est éteint. Je vous aiderai à le configurer et inclurai un guide étape par étape.
À quelle fréquence le scraper peut-il s’exécuter ?
Par défaut, je le configure pour qu’il s’exécute une fois par jour, mais nous pouvons le personnaliser (par exemple toutes les 6 heures). Gardez toutefois à l’esprit qu’une exécution trop fréquente peut bloquer votre IP ou consommer le quota gratuit de GitHub, discutons donc du planning au préalable.
Le code source est-il inclus ?
Oui, à 100 %. Chaque package inclut le code source complet et un guide de configuration, de sorte que vous puissiez l’utiliser, le modifier ou le déplacer où bon vous semble.