Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Développeur Fullstack Backend, Data ML et analyses
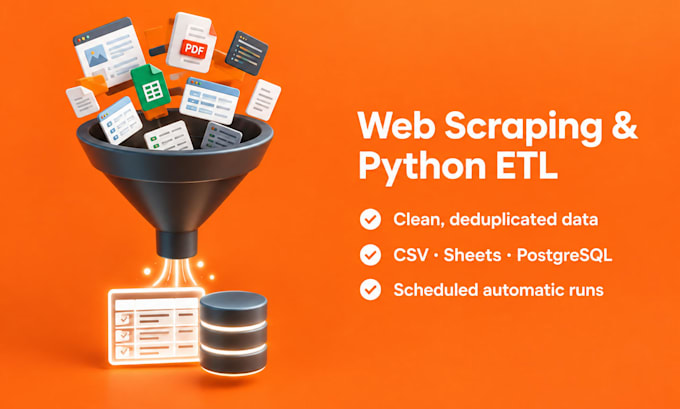
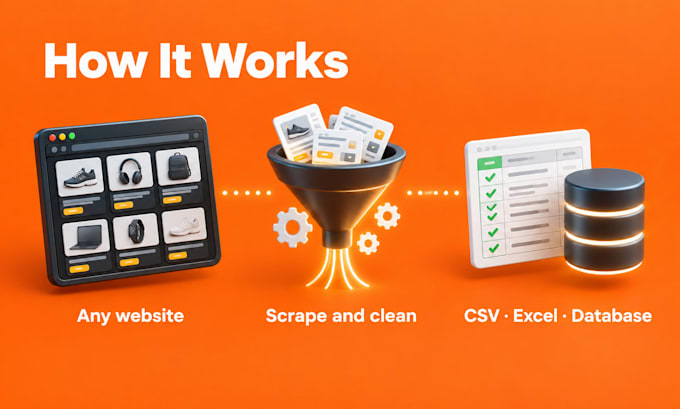
Vous avez besoin de données issues de sites web, de PDFs ou de feuilles de calcul désorganisées, réunies dans une seule table ou une base de données propre ? J’écris des scrapers Python et des pipelines ETL qui fonctionnent de manière fiable, pas des scripts ponctuels qui cassent la semaine prochaine.
Ce que vous obtenez :
Je conçois ces pipelines pour une plateforme analytique traitant des millions d’enregistrements officiels.
Veuillez me préciser la source et les champs dont vous avez besoin avant de commander. Je n’extrais que des données publiques et respecte les conditions d’utilisation des sites.
Technologie:
Python
•
Google Sheets
•
Excel
•
Beautiful Soup
Technique:
Automatisé(e)
Traduction automatique
Pouvez-vous scraper des sites avec connexion ou captcha ?
Je ne contourne pas les captchas ni les restrictions d’accès. Les données derrière une connexion ne peuvent être obtenues que depuis votre compte et avec votre permission.
Vais-je obtenir le code source ?
Oui, dans chaque package, avec un court fichier README expliquant comment le relancer.
Que faire si le site change plus tard ?
Les sites évoluent au fil du temps. Contactez-moi et je mettrai à jour le scraper pour qu’il continue à fonctionner.