Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
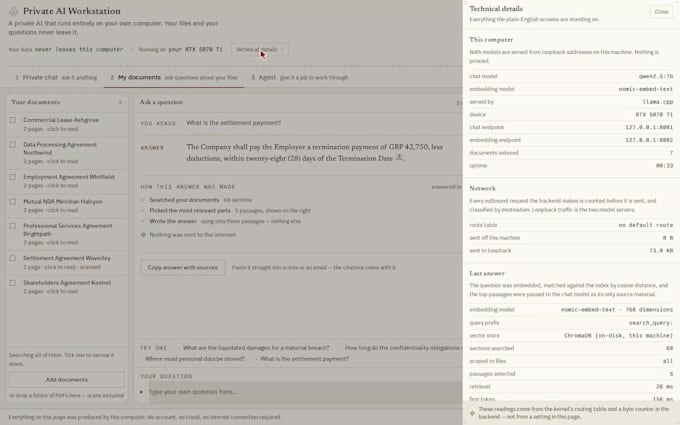
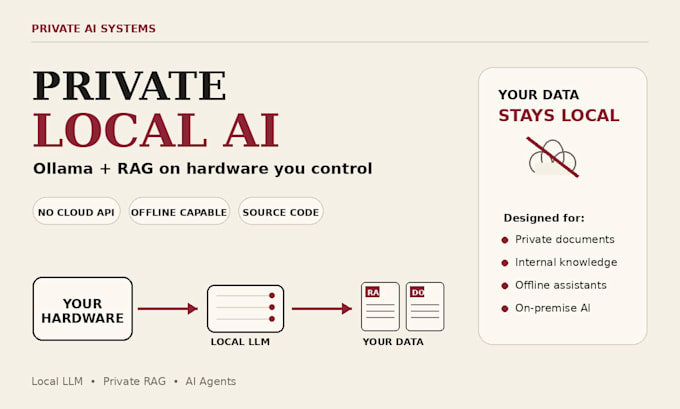
Exécutez un LLM privé local sur le matériel que vous contrôlez sans envoyer de prompts, de documents ou de données sensibles aux API de modèles externes.
Je crée des systèmes d’IA locaux avec Ollama, llama.cpp, RAG, des bases de données vectorielles et des workflows d’agents personnalisés pour les entreprises et les équipes qui ont besoin de confidentialité.
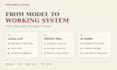
CE QUE JE PEUX DÉPLOYER
IDÉAL POUR
Les bases de connaissances internes, documents confidentiels, opérations juridiques/financières, recherche privée, assistants hors ligne et équipes évitant les coûts récurrents des API cloud d’IA.
Votre système peut être configuré pour exécuter l’inférence et la recherche de documents entièrement sur votre machine ou réseau privé.
Contactez-moi avant de commander avec votre OS, CPU, GPU/VRAM, RAM et cas d’utilisation souhaité afin que je puisse confirmer le modèle et le package appropriés.
Local AI Developer
Langues
Traduction automatique
Traduction automatique
Ai-je besoin d'un ordinateur puissant pour faire fonctionner cela ?
Cela dépend du modèle et de la charge de travail. Il est recommandé d'utiliser une GPU NVIDIA dédiée avec une mémoire VRAM suffisante pour une inférence plus rapide, mais les modèles plus petits peuvent également fonctionner sur des CPU et des Macs Apple Silicon. Envoyez-moi votre CPU, GPU/VRAM, RAM et cas d'utilisation, et je pourrai vous conseiller une configuration réaliste.
Cela nécessite-t-il une connexion internet active pour fonctionner ?
Aucune connexion internet n'est nécessaire pour le système local principal une fois que les modèles et dépendances requis sont installés. Des intégrations externes optionnelles peuvent nécessiter un accès réseau.
Mes prompts et documents seront-ils envoyés à une API AI externe ?
Le déploiement peut être configuré pour que l'inférence et la récupération de documents s'effectuent sur votre propre machine ou réseau privé, sans envoyer de prompts ou de documents aux API de modèles externes.
Quels documents le système RAG peut-il utiliser ?
Les sources typiques incluent PDF, DOCX, TXT, CSV et le contenu de bases de connaissances structurées. Demandez d'abord si vous avez des PDFs scannés, des formats inhabituels ou une grande base de données existante.
Reçois-je le code source et les fichiers de configuration ?
Oui, pour le code personnalisé créé pour votre projet. Les logiciels et modèles tiers restent soumis à leurs propres licences. Je fournis également la configuration convenue et la documentation de transfert.
Pouvez-vous le rendre totalement air-gapped ?
Oui, lorsque le logiciel sélectionné, les fichiers de modèle et votre environnement supportent un déploiement air-gapped. Indiquez cette exigence avant de commander pour que le périmètre inclue la gestion des dépendances hors ligne.
Pouvez-vous l'installer sur Windows, Linux, macOS ou un serveur ?
Oui, en fonction de votre matériel et de la pile choisie. Les systèmes Apple Silicon, GPU NVIDIA, machines CPU-only et configurations VPS/serveur peuvent tous être supportés avec différents choix de modèles.
L'ajustement ou la formation du modèle est-il inclus ?
Non, pas par défaut. Ce service se concentre sur le déploiement, RAG, l'intégration et les workflows d'agents locaux. L'ajustement fin est un périmètre séparé et doit être discuté avant la commande.
Comment le déployez-vous sur mon matériel ?
Je fournis les fichiers du projet et les étapes de déploiement, et je peux guider la configuration via la communication sur Fiverr. La méthode exacte dépend de votre environnement et de vos contraintes d'accès.
Que dois-je envoyer avant de commander ?
Votre système d'exploitation, modèle de CPU, GPU et VRAM, RAM, stockage disponible, cas d'utilisation cible, types de documents/données, interface préférée, et si vous souhaitez une opération hors ligne ou air-gapped.