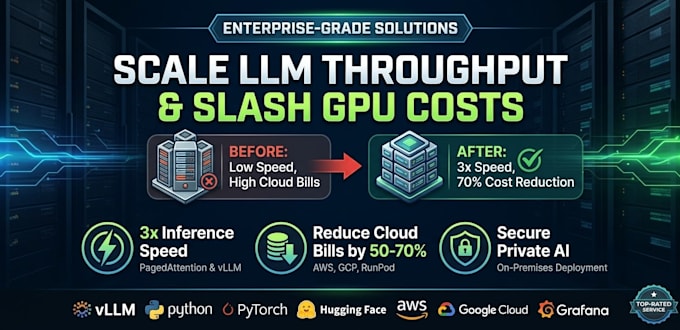
J'optimiserai l'infrastructure des llm, déployerai vllm et réduirai les coûts cloud gpu


À propos de ce service
Traduction automatique
Vos factures mensuelles AWS, GCP ou RunPod pour les GPU explosent-elles ? Votre débit LLM est-il limité par la latence ?
Je suis Expert en infrastructures LLM et Architecte privé A.I. J'aide les entreprises d'IA et les équipes d'ingénierie à optimiser les déploiements LLM open source (Llama 3, Mistral, DeepSeek) afin de maximiser le débit des demandes et de réduire fortement les coûts d'infrastructure cloud.
Ce que je peux faire pour vous :
- Déploiement vLLM et PagedAttention : Multipliez le débit des requêtes par 3 à 4 par rapport aux pipelines Hugging Face standard.
- Quantification du modèle (AWQ / GPTQ / FP8) : Réduire l'utilisation de VRAM jusqu'à 60-70 % sans perte notable de précision.
- Optimisation des coûts cloud GPU : Réduire les dépenses GPU mensuelles sur AWS/GCP/RunPod tout en servant plus d'utilisateurs simultanés.
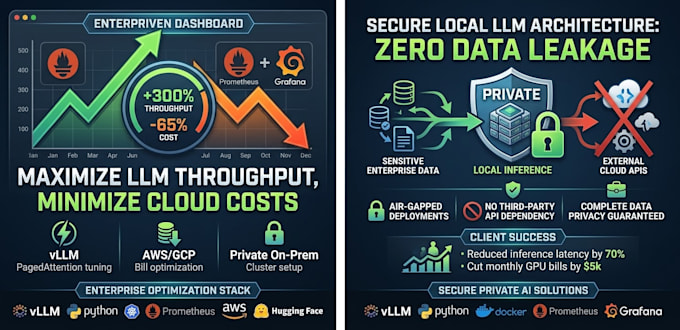
- Migration Private AI et On-Premises : Déployer des LLM locaux sécurisés, isolés du réseau, sur votre infrastructure pour une confidentialité totale des données.
- Surveillance et analytique : Mettre en place des tableaux de bord Prometheus + Grafana pour suivre la latence, la vitesse de génération de tokens (tokens/s) et l'utilisation du GPU en temps réel.
️ Pourquoi me choisir ?
- RÉTROIT SUR INVESTISSEMENT ÉLEVÉ : Mes configurations d'optimisation d'infrastructure se financent d'elles-mêmes dès le premier mois d'économies sur le cloud du serveur.
- Livraison prête pour la production : Environnements propres Dockerisés et automatisés
Découvrez Biprojit Adhika
Principal Architect LLM Infrastructure Private AI
- DeBangladesh
- Membre depuisoct. 2026
Langues
Anglais
Traduction automatique
Mon portfolio
FAQ
Traduction automatique
Comment réduisez-vous les coûts cloud GPU sans perdre en précision du modèle ?
Nous utilisons vLLM avec PagedAttention et des techniques de quantification avancées (AWQ/FP8) pour faire tenir des modèles plus volumineux dans des footprints VRAM plus petits tout en conservant une précision supérieure à 99 %.