Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Conversion PDF en texte, bibliothèques hors ligne consultables
Vos contrats et documents techniques sont stockés sur votre propre ordinateur. Trouver une clause
signifie ouvrir les fichiers un par un, et tous les outils cloud qui résolvent cela envoient vos
fichiers sur les serveurs de quelqu’un d’autre.
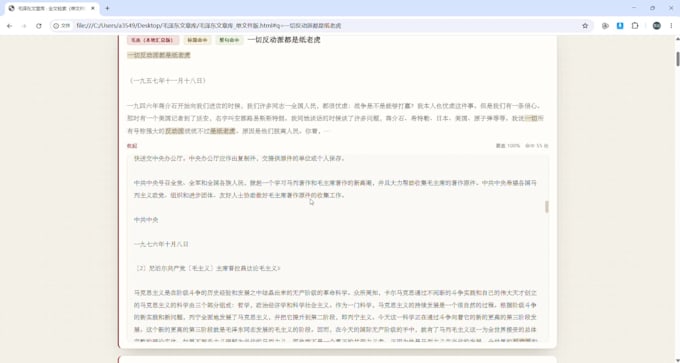
Je crée l’inverse : une bibliothèque consultable qui fonctionne entièrement sur votre ordinateur.
CE QUE VOUS OBTENEZ
Pas d’installation. Pas de Python. Pas de GPU. Pas de ligne de commande. Un fichier .html, double-cliquez et recherchez. Pas de compte, pas d’internet.
Chaque résultat indique le document source et la page d’où il provient.
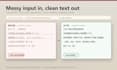
Les en-têtes en-tête, les numéros de page et les lignes dupliquées sont nettoyés.
CE QUE ÇA NE FAIT PAS
- Recherche par mot-clé, pas sémantique : les codes exacts fonctionnent bien, "trouver la clause concernant le paiement tardif" fonctionne moins bien.
- Les pages scannées nécessitent une OCR. Les scans propres vont bien, l’écriture manuscrite souvent pas.
- Le texte OCR peut contenir des erreurs. Utile pour la recherche, pas pour citer comme une autorité.
OPTIONS SUPPLÉMENTAIRES
- Connexion à des sources de données : je connecte des sources supplémentaires (base de données, cloud,
site web) dans la même bibliothèque.
- Intégration API : ajoute une interface de questions-réponses utilisant votre propre clé API.
Vos documents ne quittent jamais votre machine.
- Inclure le code source : le pipeline Python qui construit la bibliothèque, pour que vous puissiez
la reconstruire vous-même plus tard.


Technologie:
Excel
•
Python
•
Autres
Traduction automatique
Dois-je l’héberger ou payer un abonnement ?
Non. Il s’agit d’un seul fichier .html qui s’ouvre hors ligne. Rien n’est uploadé sur un serveur.
Pouvez-vous traiter le chinois ?
Oui. J'ai constitué une bibliothèque consultable de plus de 5 000 articles chinois (9,6 millions de caractères) provenant de PDFs scannés et de pages web. Les documents en chinois, anglais et japonais sont tous acceptés. (Je suis chinois, donc cette partie est facile.)
Quels types de fichiers acceptez-vous ?
PDF basés sur du texte, PDFs scannés (OCR), fichiers Word et autres fichiers Office, texte brut, et pages web. Envoyez-moi un échantillon et je confirmerai avant que vous passiez commande.
Est-ce vraiment hors ligne ? Où vont mes documents ?
Nulle part. Tout est installé sur votre machine et livré sous forme d’un seul fichier .html. Pas de compte, pas de téléchargement, et pas besoin d’internet pour rechercher — vous pouvez débrancher le câble réseau et cela fonctionne toujours.
Peut-il répondre à des questions en langage simple, comme un chatbot ?
Pas dans les packages standard — ceux-ci offrent une recherche par mots-clés. Si vous souhaitez une interface question-réponse, ajoutez l’option "API integration" : elle utilise votre propre clé API et garde vos documents sur votre machine.
Qu’en est-il des documents scannés et de l’écriture manuscrite ?
Les pages scannées sont traitées avec OCR. Les scans propres et haute résolution fonctionnent bien. L’écriture manuscrite ne fonctionne souvent pas, et le texte OCR peut contenir des erreurs — c’est correct pour la recherche, mais pas pour citer.
Puis-je ajouter plus de documents plus tard ?
Oui. Avec l’option "Include source code", vous obtenez le pipeline Python et pouvez reconstruire la bibliothèque vous-même chaque fois que vous ajoutez des fichiers. Sans cette option, contactez-moi et je vous ferai une offre pour un petit travail de suivi.
Et si mon ensemble dépasse 3000 pages, ou mélange PDFs et pages web ?
Contactez-moi avant de commander. Je regarderai vos fichiers et vous enverrai une offre personnalisée.