Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
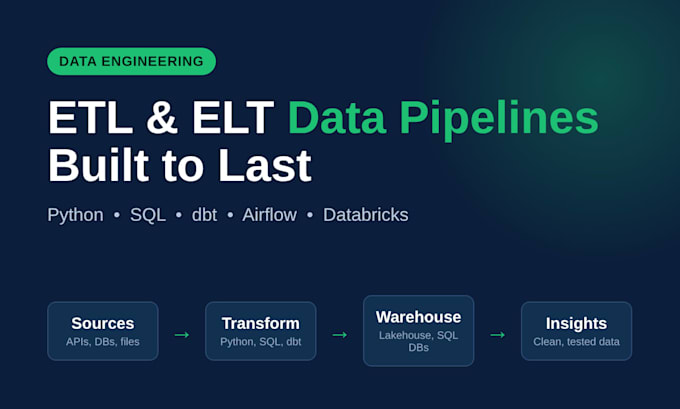
Ingénieur Data pour pipelines ETL et ELT, SQL, Python, dbt, Databricks
Vous cherchez des pipelines de données fiables qui transforment des données brutes en tables propres et prêtes à l’analyse ? Je suis ingénieur Data (Top Rated sur Upwork, 100% de réussite, plus de 1000 heures) et je construis des pipelines ETL/ELT qui sont testés, documentés et faciles à maintenir.
CE QUE VOUS OBTENEZ
MON PROCESSUS
Vous vous demandez quel package convient le mieux ? Envoyez-moi un message avant de commander et je vous recommanderai le périmètre adapté.
Traduction automatique
Avec quels outils et plateformes travaillez-vous ?
Python, SQL, dbt, Apache Airflow, PySpark et Databricks, avec Postgres et d’autres bases de données relationnelles. J’intègre également des APIs, des fichiers plats et du stockage cloud. Indiquez-moi votre stack et je travaillerai avec.
Que reçois-je à la livraison ?
Code source bien commenté, un README succinct avec les étapes d’installation et d’exécution, et une démonstration du fonctionnement du pipeline. Les forfaits Standard et Premium incluent également un audit initial des données et des recommandations de conception.
