Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Professionnel senior en Data AI
Pages web désordonnées, flux ou comptes Instagram transformés en un tableau propre, dédupliqué, que vous pouvez interroger, rafraîchi selon un calendrier, avec un tableau de bord ou une API en haut.
La différence avec un simple scraper : une étape d'IA lit chaque élément et remplit les champs que les regex ne peuvent pas, comme la catégorie, la gamme de prix, le sentiment, les entités ou la date de l'événement cachée dans une légende. La sortie est validée selon le schéma avant d'atteindre la base de données, ainsi les réponses mal formées échouent bruyamment au lieu de polluer vos données.
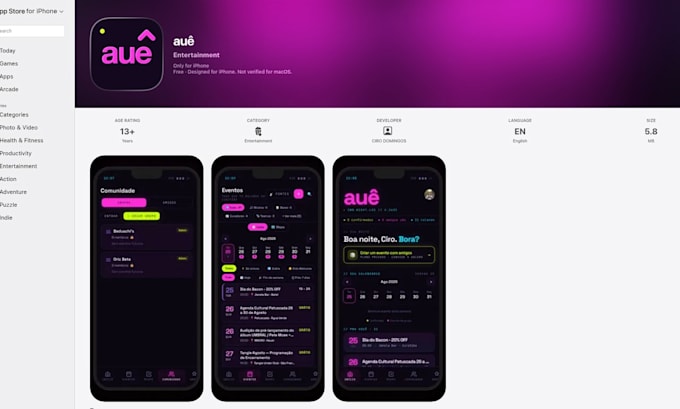
Preuve : mon application d'événements ingère environ 80 comptes Instagram via Apify et utilise Claude pour extraire les champs d'événements à partir des posts et des images chaque jour. Mon scraper de marque fait la même chose pour les attributs de marque. Les deux liens sont sur mon profil.
Ce que vous obtenez : la pipeline déployée sur Railway ou votre hébergeur, la table en SQLite ou Postgres, un tableau de bord Streamlit ou un endpoint FastAPI, et le coût de chaque exécution enregistré.
Comment commencer : envoyez deux pages d'exemple et les colonnes souhaitées. Vous recevrez un tableau d'échantillon de 100 lignes avant l'exécution complète.
Ce qui n'est pas inclus : sites qui interdisent le scraping dans leurs conditions, logins, captchas.
Technologie:
Python
•
Google Sheets
•
sélénium
•
Playwright
•
Pandas
Technique:
Automatisé(e)
Traduction automatique
Peut-il fonctionner sur mon serveur ?
Oui, ou sur Railway sous votre compte.
Quel est le coût de fonctionnement ?
Généralement moins de 20 $ par mois ; chaque exécution enregistre son coût.