Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Full Stack, Backend et Data Engineer
Convertissez les PDFs numériques et les formulaires numérisés en données structurées que votre équipe peut exploiter.
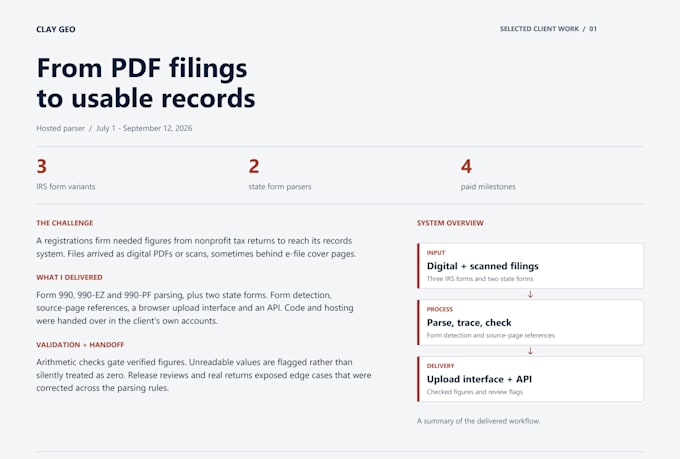
Je mets en place des flux d’extraction Python réutilisables pour des mises en page de documents convenues, avec sortie CSV ou JSON et vérifications des champs manquants ou invalides. Un projet client terminé incluait un parseur de données PDF personnalisé.
Le pack Basic couvre une mise en page PDF numérique unique. Le pack Standard ajoute l’OCR pour les documents scannés revus. Le pack Premium ajoute davantage de mises en page et un point final d’API d’extraction pour votre application. Chaque pack inclut le code source, un échantillon de sortie, les références de pages sources, des indicateurs de validation et des notes de configuration/transmission.
Je passe en revue des échantillons représentatifs au préalable, convient des champs et des résultats attendus, puis teste le parseur sur cet échantillon. Les résultats OCR dépendent de la qualité du document; le flux signale les exceptions détectées pour révision.
Les packs couvrent les mises en page indiquées, le nombre total de champs et les pages de test initiales. Envoyez des documents d’exemple et la sortie souhaitée avant de commander. Des archives plus volumineuses, des tableaux complexes, des mises en page hautement variables ou des intégrations supplémentaires peuvent faire l’objet d’un devis séparé. Les frais d’hébergement et de traitement par des tiers sont distincts.


Technologie:
Python
Traduction automatique
Qu’entend-on par mise en page ou par champ ?
Une mise en page est un gabarit de document cohérent. Un champ est une colonne de sortie ou une clé JSON ; les limites de champ s’entendent comme le total prévu par le schéma convenu. Les tableaux complexes ou des variations majeures de gabarit nécessitent une revue séparée.
Pouvez-vous traiter des PDF scannés et de l’écriture manuscrite ?
Standard et Premium incluent l’OCR pour les scans revus. L’écriture manuscrite, les pages dégradées et les mises en page très variables nécessitent une revue d’échantillon et peuvent nécessiter un périmètre personnalisé.
Comment vérifiez-vous la qualité de l’extraction ?
Je compare la sortie avec des valeurs d’échantillon convenues et j’en rends compte les résultats. Les valeurs manquantes ou invalides reçoivent des indicateurs de validation. L’OCR peut comporter des erreurs, je ne garantis donc pas une précision parfaite.
Ce qui est inclus dans la livraison et les révisions ?
Code source, sortie d’exemple, références des pages sources, indicateurs de validation et notes de configuration. Le pack Premium ajoute un point final API. Les révisions permettent d’affiner l’extraction convenue ; de nouveaux gabarits, champs ou intégrations constituent un périmètre additionnel.