Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Je crée des automatisations qui font gagner du temps et réduisent le travail manuel
Niveau 1
Répond à certains critères de performance et présente un fort potentiel sur la place de marché.
Je vais créer un pipeline de données automatisé qui collecte, nettoie, transforme et envoie vos données professionnelles là où elles doivent aller.
Je peux travailler avec des API, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, stockage cloud et autres systèmes compatibles.
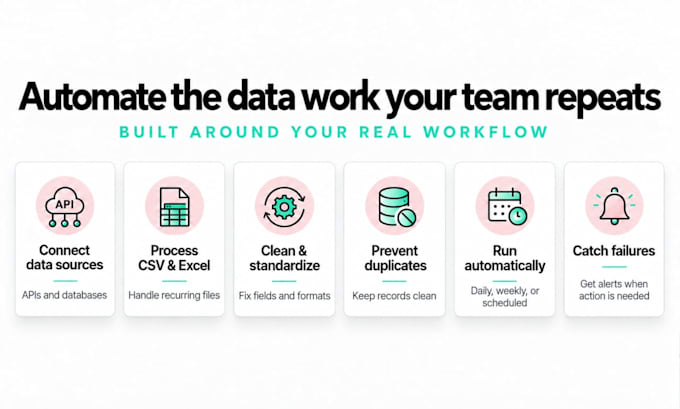
Selon le package, votre pipeline peut inclure :
Extraction de données et connexions API
Nettoyage, cartographie, filtrage et déduplication
Vérification et contrôle de la qualité des données
Exécutions automatiques programmées
Journalisation des erreurs et alertes en cas d’échec
Tests, documentation et déploiement
Ce service est idéal pour les tâches de données récurrentes, les flux de reporting, les mises à jour de bases de données et le transfert de données entre systèmes.
Veuillez m’envoyer un message avant de commander avec votre source de données, votre destination, un exemple de données et le processus que vous souhaitez automatiser afin que je puisse confirmer le bon package.


Outils et plateformes:
Autres
Traduction automatique
Qu’est-ce qu’un pipeline de données ou pipeline ETL ?
C’est un processus automatisé qui collecte des données d’une source, les nettoie ou les transforme, puis les envoie à un autre système. Par exemple : API → nettoyage et validation des données → PostgreSQL.
Avec quelles sources de données pouvez-vous travailler ?
Les sources courantes incluent les API REST, CSV, Excel, JSON, PostgreSQL, MySQL, Supabase, stockage cloud et autres systèmes avec API ou connexions à des bases de données accessibles.
Le pipeline peut-il fonctionner automatiquement ?
Oui. Les packages standard et premium peuvent inclure des exécutions programmées telles que le traitement horaire, quotidien ou hebdomadaire.
Pouvez-vous nettoyer, combiner ou transformer mes données ?
Oui. Cela peut inclure la renommée de champs, le formatage des dates, le filtrage des enregistrements, la suppression des doublons, la jointure de jeux de données, la conversion de valeurs et l’application de règles métier.
Pouvez-vous connecter une API à ma base de données ?
En général, oui. Veuillez m’envoyer les détails de l’API et de la destination avant de commander pour que je puisse confirmer l’accès et la faisabilité.
Que se passe-t-il si le pipeline échoue ?
Selon le package, je peux inclure la journalisation, la validation, les alertes d’échec, la logique de réessai et d’autres mesures de gestion des erreurs.
Vais-je recevoir le code source et la documentation ?
Oui. Le code source convenu et la documentation de configuration sont inclus pour que vous ne soyez pas lié à la livraison.
Quels types de projets ne sont pas inclus dans ces packages ?
Les grands entrepôts de données d’entreprise, l’architecture Spark ou Databricks, le streaming à l’échelle Kafka, les migrations majeures et autres systèmes complexes de data-engineering nécessitent une définition séparée et une offre sur mesure.
Dois-je vous contacter avant de commander ?
Oui. Veuillez m’envoyer d’abord un message avec votre source de données, votre destination, un exemple de données et le workflow souhaité afin que je puisse confirmer le bon package et la portée.