Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Chaque heure que votre équipe passe à copier des données de PDFs dans Excel est une heure perdue et chaque erreur manuelle coûte plus cher.
Je suis ingénieur en systèmes backend et IA. J'ai créé un système d'extraction de documents en production qui a traité plus de 20 000 documents réels, et je vais créer le même type de système pour votre entreprise.
Ce que vous obtenez :
Données structurées provenant de factures, contrats, lettres de voiture, rapports ou tout autre type de document
Résultat exactement comme vous le souhaitez : Excel, CSV, JSON ou intégration directe à une base de données/API
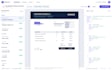
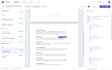
Surlignage de la source : chaque valeur extraite est retracée à son emplacement précis dans le PDF original, ce qui permet de vérifier en quelques secondes au lieu de plusieurs heures
Scores de confiance par champ, pour que votre équipe ne vérifie que ce qui doit l’être réellement
Pourquoi moi :
Expérience réelle en production, pas seulement des scripts (plus de 20 000 documents traités)
Ingénieur backend Python et Java, je peux m’intégrer à vos systèmes existants
Communication claire et dates de livraison honnêtes
Envoyez-moi un exemple de document (ou une version redactée) et je vous dirai exactement ce qui est réalisable et à quel coût avant de passer commande.
AI Automation Engineer, Document Data Extraction and Custom AI Systems
Langues
Traduction automatique
Traduction automatique
Quels types de documents pouvez-vous traiter ?
Tout PDF basé sur du texte ou scan : factures, bons de commande, lettres de voiture, contrats, formulaires d’assurance, rapports financiers. Envoyez un exemple en premier et je confirmerai la faisabilité.
Que signifie « surlignage de la source » ?
Pour chaque champ extrait (par exemple le total de la facture), le système retourne également sa position exacte dans le PDF original, vous permettant de vérifier instantanément les résultats par rapport à la source.
Gérez-vous des documents numérisés ?
Oui — scans imprimés via OCR. Écriture manuscrite : selon le cas, envoyez un exemple en premier.
Cela peut-il fonctionner sur mon infrastructure ?
Oui. La version premium inclut le support de déploiement (Docker, cloud ou sur site), ainsi vos données ne quittent jamais votre environnement.
Qu'en est-il de la confidentialité des données ?
Je signe des NDA et peux construire la pipeline pour traiter les documents dans votre propre infrastructure.


