Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Analyste de données en santé et statisticien fournissant des insights exploitables
Vous avez besoin de prédire un résultat à partir de votre jeu de données, comme un diagnostic, un churn ou un risque ? Je crée et compare des modèles de classification en machine learning, et j'explique les résultats en langage simple.
Ce que je fais :
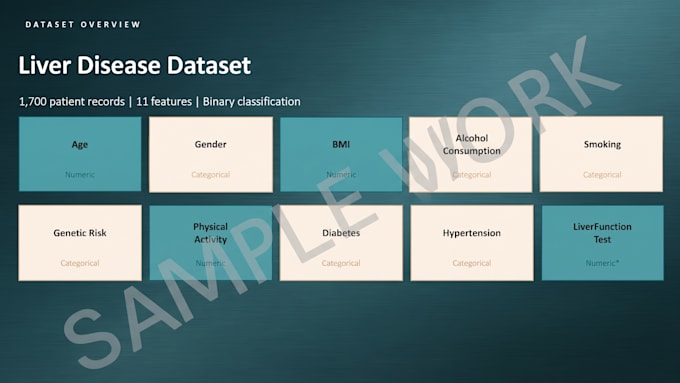
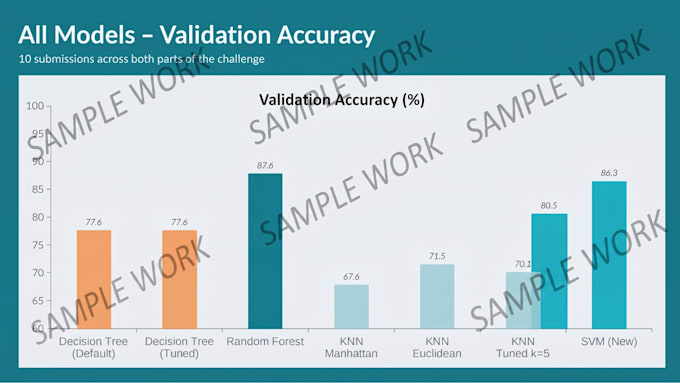
Exemple de travail : J’ai créé un modèle de prédiction de maladies du foie sur 1 700 dossiers de patients. Random Forest a obtenu un score de 0,907 sur le leaderboard Kaggle, surpassant Decision Tree, KNN et Naïve Bayes.
Veuillez envoyer : votre jeu de données, la variable cible et votre délai.
Langage de programmation:
Python
•
R
•
Colab
Frameworks:
Scikit-learn
•
Panda
APIs:
Microsoft Computer Vision AI
Outils:
Excel
•
Stata
•
Colab