Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA

Traduction automatique
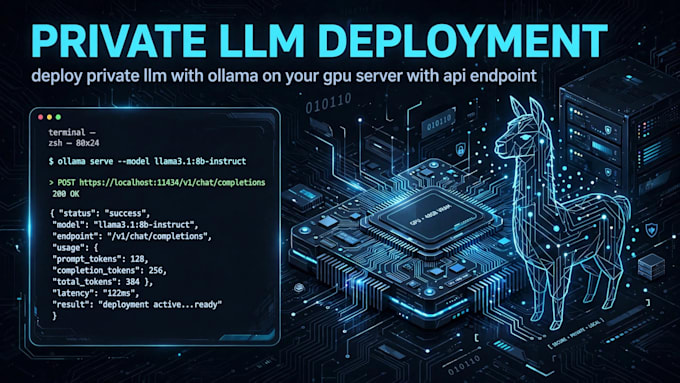
Vous souhaitez votre propre modèle d’intelligence artificielle privé fonctionnant 24h/24 et 7j/7 ? J’installe Ollama (ou llama.cpp) sur votre instance cloud GPU, récupère le modèle de votre choix et le expose sous forme d’endpoint API compatible OpenAI — avec une interface Web chat en option.
Ce que vous obtenez :
- Ollama / llama.cpp installés et optimisés sur votre instance GPU
- Modèle de votre choix préinstallé et opérationnel
- Endpoint API compatible OpenAI pour vos applications
- Option : interface de chat WebUI
- Conseils de location GPU si vous n’avez pas encore de serveur (vous louez dans votre propre compte, je recommande l’option la moins chère adaptée à votre modèle et à votre budget)
Ce dont j’ai besoin de votre part :
- Accès à l’instance GPU (connexion SSH)
- Le modèle que vous souhaitez utiliser (ou votre cas d’usage — je vous en recommanderai un)
Python Developer , Web Scraping and Automation Specialist
Langues
Traduction automatique
Traduction automatique
Ai-je besoin de mon propre serveur GPU ?
Oui — vous louez l’instance GPU dans votre propre compte (RunPod, Vast.ai, etc.). Je recommande l’option la moins coûteuse pour votre modèle et votre budget, puis j’installe et configure le tout.
Quels modèles pouvez-vous déployer ?
Tout modèle pris en charge par Ollama ou llama.cpp — Llama, Qwen, Mistral, DeepSeek et d’autres. Indiquez-moi votre cas d’utilisation et je vous en recommanderai un.
Mes applications peuvent-elles accéder au modèle via l’API ?
Oui — je fournis un endpoint compatible OpenAI, donc tout ce qui fonctionne avec l’API OpenAI fonctionne avec votre modèle privé.
