Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
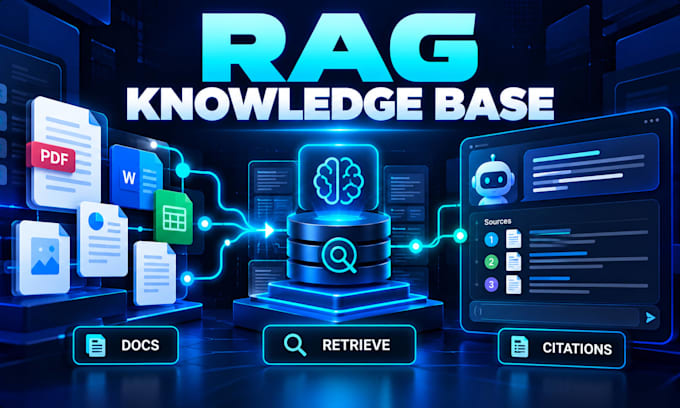
Construit une base de connaissances IA qui répond à partir de vos documents avec références sources.
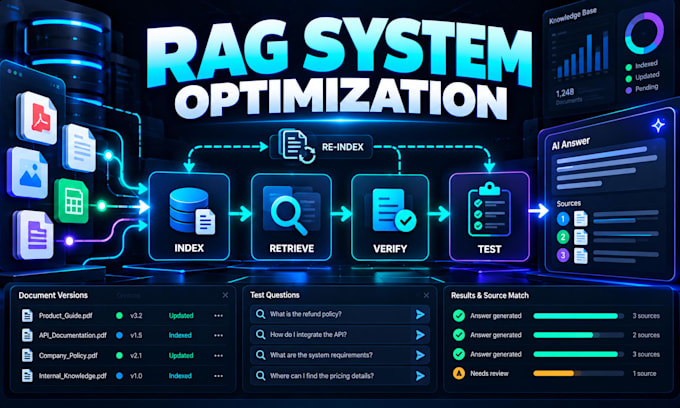
Je crée des systèmes RAG pour les questions/réponses sur des documents et la recherche de connaissances internes. PDF, DOCX, FAQ, SOP, manuels, pages web ou bases de données sélectionnées sont traités et indexés afin que les réponses pointent vers les sources pertinentes.
CE QUE JE PEUX CONSTRUIRE
J’utilise Python, des API LLM et des cadres RAG adaptés ; la stack dépend de vos données et de votre application.
Des limites de documents/source s’appliquent. Les migrations importantes, les graphes de connaissances, les interfaces SaaS personnalisées et les autorisations multi-locataires complexes nécessitent un périmètre sur mesure.
Envoyez les types de documents, le volume, des questions d’exemple, la stack actuelle, les rôles utilisateur et le résultat visé avant de commander.
AI Systems Specialist, Automation, Generative AI and Content Workflow for Smart
Langues
Traduction automatique
Traduction automatique
Pouvez-vous construire une base de connaissances à partir de mes PDFs et documents d’entreprise ?
Oui. Je peux construire une base de connaissances RAG en utilisant des PDFs supportés, des fichiers DOCX, des FAQ, des SOP, des manuels, des pages web ou d’autres sources convenues. Les fichiers numérisés, les tableaux complexes et les formats inhabituels peuvent nécessiter un traitement supplémentaire.
Les réponses incluront-elles des citations sources ?
Des réponses basées sur les sources et des citations font partie du périmètre convenu. Le niveau de détail des citations dépend du parseur de source et si les fichiers d’origine exposent des métadonnées de page ou de section fiables.
Le système peut-il éviter de fabriquer des réponses ?
Je peux configurer des réponses fondées sur la récupération et un recours lorsque les preuves récupérées ne soutiennent pas une réponse. Aucun système d’IA ne peut garantir zéro erreur, des tests représentatifs et des limites claires restent donc importants.
Pouvez-vous corriger un chatbot RAG existant qui récupère des informations incorrectes ?
Oui. Je peux examiner l’extraction, le découpage, les embeddings, la recherche, les filtres, le classement et le comportement de génération des réponses. Le périmètre approprié dépend s’il s’agit d’une correction contenue ou d’une refonte plus large.
Les documents peuvent-ils être mis à jour sans reconstruire toute la base de connaissances ?
Oui, lorsque l’architecture choisie le permet. Je peux configurer les mises à jour des documents et la réindexation afin que les nouvelles versions remplacent le contenu obsolète plutôt que de laisser des informations périmées dans les résultats de récupération.
Pouvez-vous utiliser Supabase et pgvector ?
Oui, lorsque cela convient au projet. Supabase prend en charge la recherche vectorielle avec pgvector et propose également des approches de recherche sémantique, par mots-clés et hybride.
Pouvez-vous restreindre l’accès à différents documents ?
Le filtrage d’accès peut être mis en œuvre lorsque l’application prend en charge l’authentification et l’architecture des données. Il doit être appliqué au niveau backend ou de la récupération et non se limiter à des instructions du prompt.
Pouvez-vous migrer une base de connaissances ou un système Q&A existant ?
Oui. Je peux examiner les sources actuelles, la conception de récupération, la base de données et les dépendances avant de proposer la migration. Les migrations plus importantes nécessitent un périmètre sur mesure après évaluation du système existant.
Cette Gig inclut-elle une application SaaS multi-locataires complète ?
Non. Cette Gig se concentre sur le système de connaissances et de récupération. Un produit SaaS complet avec gestion des utilisateurs, isolation des locataires, facturation, tableaux de bord et développement d’application appartient à la Gig SaaS IA séparée.
De quoi avez-vous besoin avant de commencer ?
Veuillez préciser votre objectif, les types de documents et le volume approximatif, des questions d’exemple, la stack actuelle, les intégrations requises, les rôles utilisateur et les préférences de déploiement. Ne transmettez pas de mots de passe ni de clés API secrètes via le chat.