Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur DevOps senior, expert en sécurité réseau et Linux
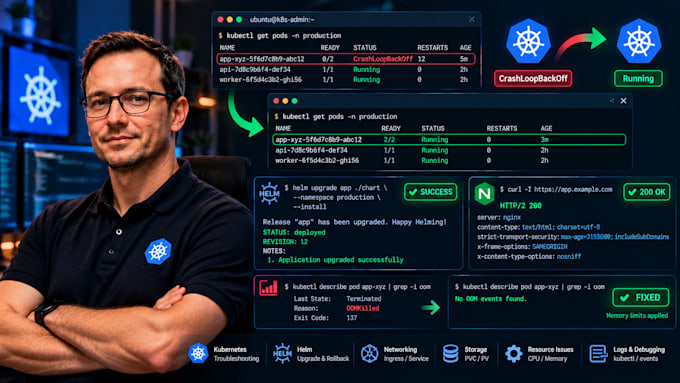
Pods Kubernetes SOS qui crashent ? Helm qui échoue ? Réseau défaillant ? Je répare rapide.
Je suis ingénieur Platform/DevOps avec plus de 5 ans d’expérience en production Kubernetes (EKS, GKE, AKS, bare-metal). Je n’improvise pas : j’utilise un playbook de débogage éprouvé (kubectl events logs metrics config) pour trouver la cause en quelques minutes.
CE QUE JE FIXE (Chaque package) :
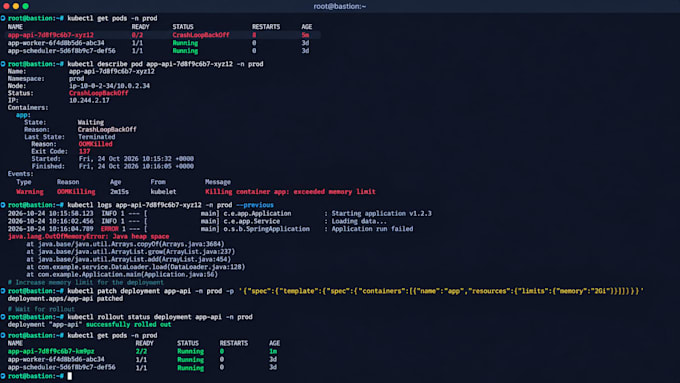
CrashLoopBackOff / OOMKilled (137) limites de mémoire, fuites, réglages runtime JVM/Go
ImagePullBackOff / ErrImagePull authentification ECR/GHCR/ACR, rôles IAM, coquilles dans les tags d’image
Pending / Unschedulable quotas de ressources, sélecteurs de nœuds, taints/tolerations, liaison PVC
Échecs Helm dépendance du chart manquante, désaccord de schéma des valeurs, erreurs de template, release bloquée
Réseau CNI (Calico/Cilium/Flannel), CoreDNS, Service/Ingress 502/504, NetworkPolicy
Problèmes ConfigMap/Secret clés manquantes, mauvais namespace, montages subPath, finalizers
Échecs de probe liveliness/readiness/startup, HTTP vs exec vs gRPC
HPA/VPA qui ne s’étendent pas, metrics-server, métriques personnalisées, métriques externes


Traduction automatique
Comment accédez-vous à mon cluster en toute sécurité ?
Vous fournissez : kubeconfig avec RBAC restreint (obtenir/lister/vues des pods, logs, événements, releases Helm) OU accès à la console cloud (EKS : aws eks update-kubeconfig, GKE : gcloud container clusters get-credentials, AKS : az aks get-credentials). Je ne demande jamais d’accès administrateur/root.
Et si le problème vient de votre code applicatif ?
Je l’identifie (trace, code de sortie, journaux) et vous indique exactement ce qu’il faut corriger. Si vous souhaitez que je patche l’image du conteneur, c’est une autre portée (envoyez-moi un message).
Pouvez-vous corriger les Helm charts écrits par quelqu’un d’autre ?
Oui. Je vais déboguer la release (helm status, helm get values, helm template), corriger les valeurs/dépendances/templates et tester avec helm upgrade --dry-run --debug.
Travaillez-vous les week-ends / soirées pour les urgences production ?
Oui. Envoyez-moi un message avec « URGENT » et votre fuseau horaire. Je répondrai en moins de 30 minutes pendant les heures de travail (UTC+3). Supplément d’urgence : +50% (Basic), +30% (Standard/Premium).