Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur expert en IA et apprentissage automatique
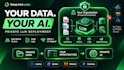
Je déploie des LLM open source de manière privée, dans votre propre compte cloud ou sur vos serveurs. Rien n’est envoyé à des API d’IA tiers.
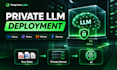
Je gère moi-même cette stack: un modèle Qwen de 32 milliards exécuté avec vLLM, derrière une API compatible OpenAI, avec des clés API, des tableaux de bord de supervision (Prometheus et Grafana) et tout empaqueté dans une seule image Docker.
Ce que vous obtenez :
Optionnel : un chatbot RAG qui répond à partir de vos documents et montre ses sources.
Idéal pour les entreprises traitant des données privées ou réglementées (cliniques, juridique, documents internes).
Envoyez-moi d’abord un message avec votre GPU ou votre cloud et le modèle que vous envisagez, et je confirmerai la bonne configuration.
Frameworks:
Scikit-learn
•
DeepPy
•
Google ML Kit
•
PyTorch
Type de données:
Code
Langage de programmation:
Python
•
R
•
SQL
•
Amazon SageMaker
Outils:
Jupyter Notebook
•
tensorflow
•
Amazon SageMaker
•
Colab
Traduction automatique
Ai-je besoin de mon propre GPU ou compte cloud ?
Les deux fonctionnent. Je peux déployer sur votre propre serveur ou sur un compte cloud que vous possédez (AWS, RunPod et similaires). Envoyez-moi un premier message et je conseillerai la taille du GPU adaptée à votre modèle.
Mes données quittent-elles mes serveurs ?
Non. Le modèle s’exécute dans votre environnement et rien n’est envoyé vers des API d’IA tierces. Je n’ai besoin d’accès que pour la configuration, puis vous pouvez le retirer.
Quels modèles pouvez-vous déployer ?
Des modèles open-source comme Qwen, Llama et Gemma, avec quantification. Le meilleur choix dépend de votre mémoire GPU et de votre cas d’usage.
L’assistant peut-il répondre à partir de mes documents ?
Oui, c’est l’option RAG facultative. Il répond à partir de vos fichiers et indique la source. Indiquez les types de documents et le volume avant de commander.
De quoi avez-vous besoin de ma part pour commencer ?
Détails sur votre GPU ou votre cloud, le modèle envisagé (si disponible) et quelles applications l’appelleront. Je confirmerai la configuration avant de commencer.


