Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Architecte de données senior
Arrêtez de perdre du temps et de l’argent sur des requêtes SQL lentes, des pipelines ETL cassés et des architectures de données non évolutives.
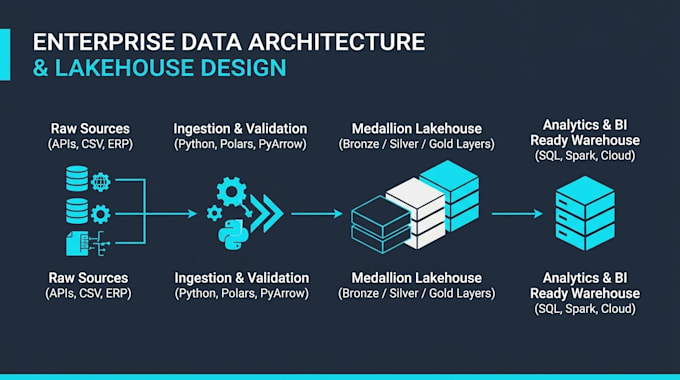
Avec plus de 15 ans d’expérience en entreprise en ingénierie des données, science des données et architecture Big Data, j’aide les entreprises à transformer des données désorganisées et peu fiables en systèmes propres et haute performance, prêts pour la production.
Comment puis-je vous aider :
Pourquoi travailler avec moi ?
Veuillez me contacter avant de passer commande avec un résumé rapide de votre stack de données actuelle
Traduction automatique
Dois-je partager des données de production sensibles ou des identifiants de base de données ?
Non. Ne partagez jamais de mots de passe de production ni d’informations personnelles identifiables confidentielles. Un échantillon de données anonymisé, le DDL du schéma, le plan d’exécution des requêtes ou une vue d’ensemble de l’architecture suffit pour diagnostiquer et concevoir votre solution en toute sécurité.
Que se passe-t-il si mon projet nécessite plus de travail que ce qui est inclus dans les packages ?
Chaque package couvre une portée de conseil, d’audit ou d’architecture clairement définie. Si votre système nécessite une mise en œuvre personnalisée plus vaste, envoyez-moi un message d’abord et je préparerai une offre sur mesure.
Avec quelles bases de données, langages et plateformes cloud travaillez-vous ?
Je travaille avec des stacks de données modernes incluant Python (Polars, PyArrow, Pandas), Apache Spark, SQL (PostgreSQL, SQL Server, MySQL, Snowflake, Redshift), services AWS, intégrations SAP et architectures lakehouse.
Proposez-vous une maintenance continue ou des sessions de suivi après livraison ?
Les livrables incluent une documentation complète pour que votre équipe puisse tout exécuter de manière indépendante. Si vous souhaitez des appels de revue supplémentaires ou des conseils continus, vous pouvez ajouter des minutes de conseil supplémentaires ou réserver une séance de suivi à tout moment.