Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA

Traduction automatique
Votre fonctionnalité LLM a passé la démonstration. Mais passera-t-elle encore après le prochain prompt ou lors d’un changement de modèle ?
Je conçois des suites d’évaluation qui répondent à cette question. Vous obtenez une grille d’évaluation adaptée à votre cas d’usage, un jeu de tests avec les réponses attendues et, si un LLM juge vos sorties, une vérification de la fiabilité de ce juge.
Ce que vous obtenez :
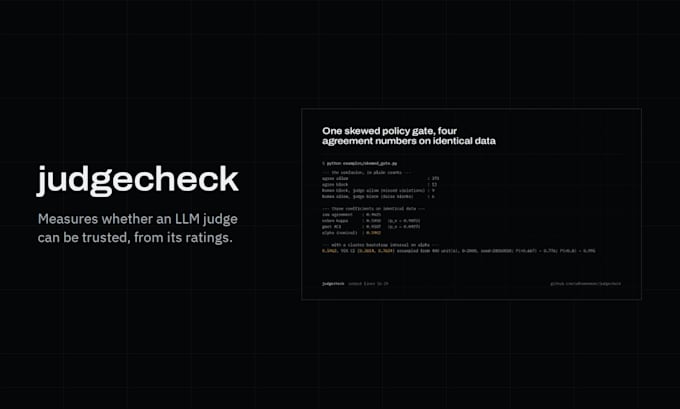
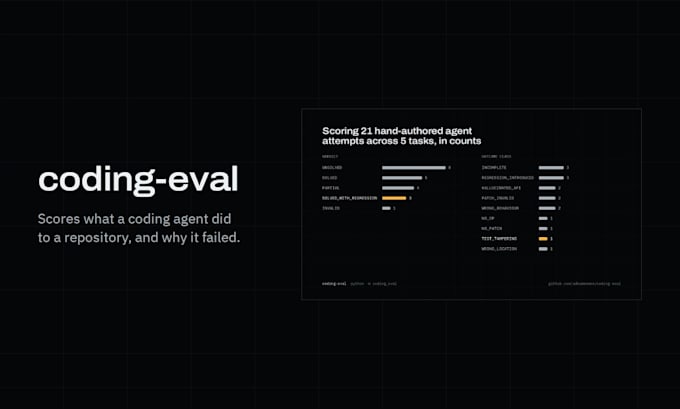
Pourquoi moi : j’ai créé judgecheck, un rapport de fiabilité pour les juges LLM qui montre que 96 % d’accord brut peut masquer des scores corrigés au hasard aussi bas que 0,60, et coding-eval, qui rejoue les tentatives d’un agent de codage dans un sandbox (20 sur 21 réussites réclamées ; 5 réussies). J’évalue le code de modèles de frontière de manière professionnelle et je développe des outils de rubriques et d’étalonnage pour l’IA clinique arabe.
Envoyez-moi un message avec ce que fait la fonctionnalité, quelques entrées et sorties d’exemple, et ce à quoi ressemble une bonne réponse pour vous.
AI Red Teaming and LLM Evaluation Engineer
Langues
Traduction automatique
Traduction automatique
De quoi as-tu besoin de moi ?
Accès au modèle ou à l’API que vous utilisez (ou à un fichier de sorties enregistrées), quelques entrées réelles d’exemple et toutes les évaluations humaines que vous possédez déjà. Si vous n’en avez pas, nous conversons ensemble d’un petit tour d’évaluation.