Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur full stack IA pour SaaS, applications mobiles et web scraping
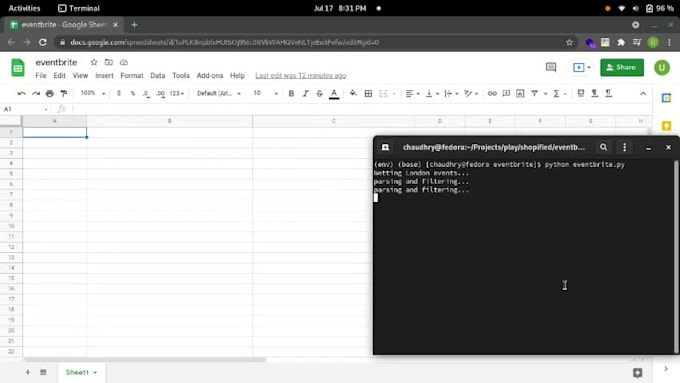
Vous avez besoin de données provenant de sites web à intervalles réguliers sans avoir à copier-coller ? Je crée des scrapers en Python qui les collectent de manière fiable et livrent des fichiers propres et structurés ou les intègrent directement dans vos systèmes.
Fort de 15 ans d’expérience en développement logiciel, je réalise des scrapers qui gèrent ce que les scripts bon marché ne peuvent pas : pages riches en JavaScript, défilement infini, pagination, connexions que vous possédez, et sites qui changent leur mise en page.
Ce que vous obtenez :
Utilisations courantes : suivi des prix des concurrents, listes de prospects issues d’annuaires publics, annonces immobilières et offres d’emploi, catalogues de produits et surveillance des avis.
Je ne scrape que des données accessibles publiquement et je respecte les conditions d’utilisation de chaque site.
Envoyez-moi le site web et les champs dont vous avez besoin, je vous confirmerai ce qui est possible avant de passer commande.



Technologie:
Python
•
NodeJS
•
scrapy
•
sélénium
•
Playwright
Technique:
Automatisé(e)
Traduction automatique
Quels types de sites web et de données sont supportés ?
Je peux extraire des données de répertoires d'entreprises publics, de boutiques e-commerce, de trackers de prix et d'annonces immobilières publiques. Les données ciblées doivent être entièrement publiques, et le projet doit respecter les normes éthiques de scraping. Je ne scrape pas de données personnelles cachées ou de dossiers privés.
Pouvez-vous gérer des sites complexes avec JavaScript dynamique ou scroll infini ?
Oui. Contrairement aux outils de scraping sans code, j'écris une architecture programmatique personnalisée en utilisant Playwright, Selenium et Python. Cela me permet de naviguer facilement dans la pagination profonde, les layouts structuraux et le rendu dynamique côté client.
Vos packages incluent-ils la propriété du code source réel ?
Les packages de base fournissent les jeux de données bruts compilés (CSV, JSON, Excel). Si vous souhaitez la propriété complète du dépôt de l'espace de travail propre, des scripts d'automatisation personnalisés ou des pipelines de déploiement cloud, nous pouvons facilement ajouter la livraison du code comme option supplémentaire adaptée dans le chat.
Comment garantissez-vous que le web scraping reste éthique et légal ?
Je ne collecte que des données accessibles au public, je respecte les limites de fréquence pour ne pas surcharge les sites, et je vous informe dès le départ si les conditions d’utilisation d’un site interdisent le scraping.