Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur de données senior
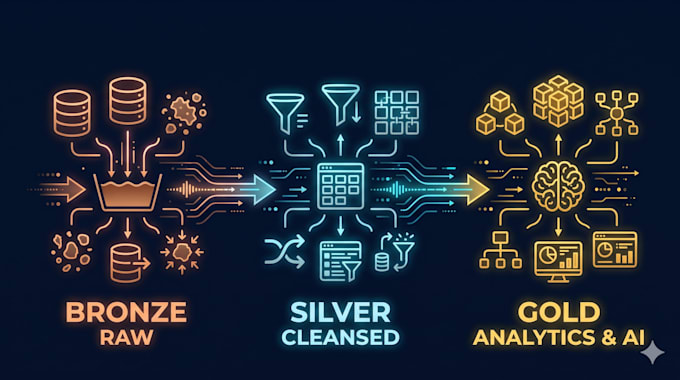
Vous avez des requêtes SQL lentes, des silos de données désorganisés ou des coûts cloud élevés ? Je suis un ingénieur de données d’entreprise (certifié Microsoft Azure) spécialisé en PySpark, Azure Databricks, Delta Lake et SQL. Je conçois, optimise et construis des architectures de données tolérantes aux pannes qui transforment des données brutes en pipelines prêts pour l’analyse et l’IA.
Ce que je peux faire pour vous :
Pourquoi travailler avec moi ?
Contactez-moi avant de passer commande afin que nous puissions nous aligner sur votre stack de données et votre périmètre !
Traduction automatique
Pouvez-vous écrire le code PySpark / SQL réel en complément du plan d’architecture ?
Oui ! En parallèle de l’audit et des plans d’architecture, j’écris des scripts PySpark prêts pour la production, des notebooks Databricks et des requêtes SQL optimisées. Envoyez-moi vos exigences pour une offre de mise en œuvre sur mesure.