Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
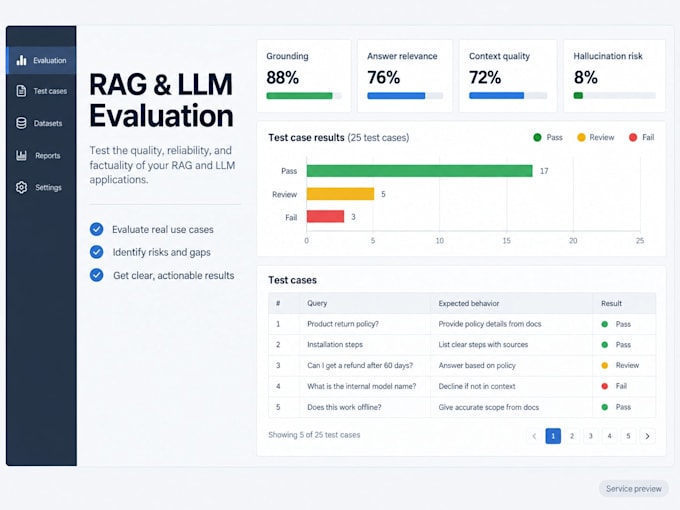
Votre application RAG ou LLM produit-elle des réponses non supportées, hors sujet ou incohérentes ? Je vais en analyser le comportement et fournir des recommandations basées sur des preuves pour l'améliorer.
Je peux évaluer :
La pertinence, la clarté et l'exhaustivité des réponses
Le fondement dans le contexte récupéré
Les hallucinations et affirmations non supportées
La qualité de la récupération et l'utilité des sources
La cohérence des citations
Les schémas d'échec et le comportement de secours
Les indicateurs de latence et de coût lorsque les données sont disponibles
Les décisions concernant le découpage, le contexte et la configuration du modèle
Selon le package, je passerai en revue les cas de test fournis, créerai un ensemble d'évaluation structuré, analyserai les échecs de récupération et de génération, et utiliserai des métriques automatisées lorsque cela est techniquement approprié. Vous recevrez un rapport clair séparant observations, preuves, limitations et recommandations prioritaires.
Veuillez fournir un accès à un environnement de test sécurisé ou des résultats exportés de l'application, les contextes récupérés, les réponses attendues si disponibles, ainsi qu'une description des utilisateurs et du cas d'utilisation prévu. Supprimez les clés API, identifiants de production et données privées des clients.
Ce service évalue un système existant. La mise en œuvre de changements majeurs, la reconstruction du pipeline RAG, le déploiement en production, etc.
Python Backend Applied AI Developer
Langues
Traduction automatique
Traduction automatique
Q : Qu'est-ce qu'un cas d'évaluation ?
R : Un cas comprend une question utilisateur, la réponse générée et le contexte ou les sources récupérées pour la produire. Les réponses attendues ou de référence sont utiles mais pas toujours nécessaires.
Q : Avez-vous besoin d'accéder à mon système de production ?
R : Non. Je préfère un environnement de test sécurisé, des résultats exportés ou une version locale reproductible. Veuillez supprimer les clés API, identifiants de production, informations personnelles et données confidentielles des clients avant de partager quoi que ce soit.
Q : Quelles métriques d'évaluation utilisez-vous ?
R : Les métriques dépendent de l'application et des données disponibles. L'évaluation peut couvrir la pertinence des réponses, la pertinence du contexte, la fidélité, le fondement dans la source, la qualité de récupération, les schémas d'hallucination, la latence et les indicateurs de coût. Des outils automatisés comme RAGAS ou des méthodes équivalentes peuvent être utilisés lorsque approprié.
Q : Allez-vous mettre en œuvre les améliorations recommandées ?
R : Ce service se concentre sur l'évaluation et les recommandations. De petites ajustements convenus peuvent être proposés séparément, tandis que des changements majeurs de pipeline, de nouvelles fonctionnalités et le déploiement nécessitent une offre personnalisée.
Q : Pouvez-vous garantir que l'évaluation éliminera les hallucinations ?
R : Aucun évaluateur responsable ne peut garantir qu'un LLM ne hallucine jamais. J'identifierai les schémas d'échec observés, les mesurerai dans la mesure du possible et recommanderai des moyens pratiques pour réduire leur fréquence et leur impact.