Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en IoT, IA et systèmes embarqués
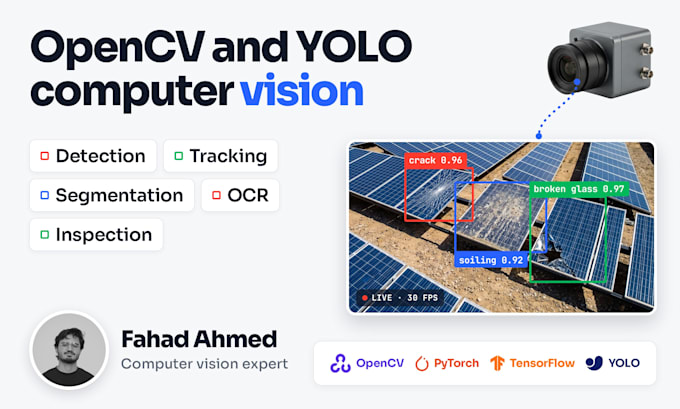
Je conçois des systèmes de vision par ordinateur et de deep learning avec OpenCV, YOLO et PyTorch : des modèles entraînés sur mesure à l’analyse vidéo en temps réel, conçus pour fonctionner de manière fiable sur votre PC, serveur ou appareil edge.
Ce que je fournis
Portée technique
Avec une formation en IA et plusieurs années d’expérience en ingénierie, je crée des systèmes de vision précis, rapides et faciles à utiliser ou à étendre pour votre équipe. Vous recevez le code source complet, les poids du modèle entraîné et la documentation.
Contactez-moi avant de passer commande. Je vais examiner votre projet et votre calendrier, puis vous envoyer un devis précis.


APIs:
Microsoft Computer Vision AI
•
Google Cloud Vision API
Langage de programmation:
Python
•
Colab
•
Autres
Outils:
Jupyter Notebook
•
opencv
•
tensorflow
•
Colab
•
PyTorch
•
Autres
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Autres
Traduction automatique
Quelles tâches de vision par ordinateur gérez-vous ?
Détection, classification, segmentation, suivi, estimation de pose, OCR, inspection visuelle, mesure, calibration et vision stéréo. Si votre tâche est différente, décrivez-la et je vous indiquerai la meilleure approche.
Ai-je toujours besoin de deep learning ?
Non. Beaucoup de tâches sont plus rapides et plus fiables avec le traitement d’image classique d’OpenCV. Je choisis entre OpenCV et deep learning en fonction de votre précision, vitesse et matériel.
Pouvez-vous entraîner un modèle avec mes propres données ?
Oui. J’annoterai vos images, entraînerai un modèle personnalisé et vous fournirai la précision, le rappel et le mAP sur un ensemble de test que vous pourrez vérifier.
Quelle sera la précision ?
Cela dépend de vos images et conditions. Je teste sur vos données réelles et vous dis honnêtement quelle précision attendre avant de commencer.
Peut-il fonctionner en temps réel ?
Oui. J’optimise avec ONNX, TensorRT ou OpenVINO et adapte la taille du modèle à votre matériel et à votre fréquence d’image.
Signez-vous des NDA ?
Oui. Je suis prêt à signer un NDA avant de discuter de projets confidentiels.
Cela peut-il fonctionner avec mes caméras ?
Oui. Je lis les caméras IP via RTSP, les caméras USB et les fichiers vidéo, et je peux traiter plusieurs flux simultanément.
Peut-il fonctionner sur un Raspberry Pi ou Jetson ?
Oui. Je déploie sur PC, serveurs cloud, Raspberry Pi et NVIDIA Jetson, et j’optimise le pipeline pour chacun.
De quoi avez-vous besoin de ma part pour commencer ?
Ce que vous souhaitez que le système voie ou mesure, des images ou vidéos d’échantillon, et où il doit fonctionner. Une brève description suffit pour commencer.
Ai-je le code source et le modèle ?
Oui. Vous recevez le code source complet, les poids du modèle entraîné et la documentation. Vous en êtes propriétaire.